在navicat导入数据时,日期格式不匹配是导致导入失败或数据错乱的主要原因。解决这个问题的核心做法是在导入向导的“映射”步骤中,手动指定目标字段的转换规则,将源数据的文本格式转换为数据库支持的日期类型。具体操作是进入导入向导后,在字段映射界面找到对应的日期列,点击下拉菜单选择“转换”,然后从预设模板中选择如yyyy-mm-dd或dd/mm/yyyy等格式,或者自定义正则表达式来解析特殊格式的日期字符串。这样设置后,navicat会在写入数据库前自动完成格式清洗和类型转换,确保数据准确入库。

如何为特定日期列配置导入映射
要为特定的日期列配置导入映射,需要在导入向导的第四步“映射”中进行操作。首先确保已正确识别了源文件(如CSV)和目标表结构。在映射列表中,找到需要处理的日期字段,其默认类型通常为“文本”。点击该字段右侧的下拉箭头,选择“转换”选项。此时会弹出一个转换配置窗口,你可以在其中选择标准的日期格式模板,例如“yyyy-MM-dd HH:mm:ss”。如果源数据格式非常规,比如包含中文“年/月/日”,则需要使用“自定义”模式并输入相应的正则表达式或格式化字符串。配置完成后,预览区域会显示转换后的结果,确认无误后即可继续执行导入。
import pandas as pd
import sqlite3

# 模拟源数据:包含非标准日期格式的CSV内容
data = {
    'id': [1, 2, 3],
    'name': ['Alice', 'Bob', 'Charlie'],
    'join_date': ['2023-10-01', '01/15/2023', '2023.11.20']
}
df = pd.DataFrame(data)

# 保存为临时CSV文件用于演示
file_path = 'temp_data.csv'
df.to_csv(file_path, index=False)

# 使用Python模拟Navicat的转换逻辑
conn = sqlite3.connect('test.db')
cursor = conn.cursor()

# 创建目标表
cursor.execute('''
CREATE TABLE IF NOT EXISTS employees (
    id INTEGER PRIMARY KEY,
    name TEXT,
    join_date DATE
)
''')

# 定义转换函数,模拟Navicat中的“转换”映射
from datetime import datetime

def parse_date(date_str):
    formats = [
        '%Y-%m-%d',       # 2023-10-01
        '%m/%d/%Y',       # 01/15/2023
        '%Y.%m.%d'        # 2023.11.20
    ]
    for fmt in formats:
        try:
            return datetime.strptime(date_str, fmt).strftime('%Y-%m-%d')
        except ValueError:
            continue
    return None

# 插入数据并应用转换
for _, row in df.iterrows():
    converted_date = parse_date(row['join_date'])
    cursor.execute(
        'INSERT INTO employees (id, name, join_date) VALUES (?, ?, ?)',
        (row['id'], row['name'], converted_date)
    )

conn.commit()

# 验证结果
cursor.execute('SELECT * FROM employees')
print(cursor.fetchall())
conn.close()
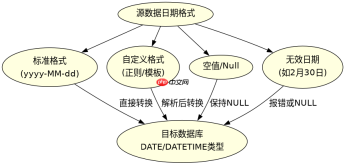
上述代码展示了如何处理多种日期格式。在实际的Navicat操作中,你不需要编写这段Python代码,而是通过图形界面的“转换”功能实现相同的效果。关键在于理解源数据的实际格式,并在映射阶段提供正确的解析规则。如果源数据中存在空值或无效日期,Navicat通常会将其保留为空或根据设置报错,这与代码中`parse_date`返回`None`的行为一致。
导入过程中遇到日期格式错误怎么办
当导入过程中出现日期格式错误时,通常是因为源数据中包含无法被当前映射规则解析的字符,或者日期本身无效(如2月30日)。解决这一问题的方法是检查源数据的质量,并在Navicat的导入设置中启用“忽略错误”或“跳过行”选项。此外,可以在导入前对源数据进行预处理,统一日期格式。在Navicat中,如果某个单元格的日期转换失败,该单元格在预览中将显示为红色或空白。你可以双击该单元格查看具体的错误信息,并调整映射规则以兼容该异常值。对于批量导入,建议先小范围测试,确认所有可能的日期变体都能被正确解析后再进行全量导入。

Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。

# 模拟处理含异常日期的数据
data_with_errors = {
    'id': [4, 5, 6],
    'name': ['David', 'Eve', 'Frank'],
    'join_date': ['2023-02-30', 'invalid', '2023-12-25']
}
df_errors = pd.DataFrame(data_with_errors)

def safe_parse_date(date_str):
    if pd.isna(date_str) or date_str == '':
        return None
    formats = ['%Y-%m-%d', '%m/%d/%Y']
    for fmt in formats:
        try:
            return datetime.strptime(str(date_str), fmt).strftime('%Y-%m-%d')
        except ValueError:
            continue
    return None  # 返回None表示转换失败

results = []
for _, row in df_errors.iterrows():
    parsed = safe_parse_date(row['join_date'])
    results.append({'id': row['id'], 'name': row['name'], 'join_date': parsed})

print(results)
# 输出: [{'id': 4, 'name': 'David', 'join_date': None}, {'id': 5, 'name': 'Eve', 'join_date': None}, {'id': 6, 'name': 'Frank', 'join_date': '2023-12-25'}]
这段代码模拟了处理异常日期的场景。在Navicat中,类似地,你可以选择在导入时跳过这些无法转换的行,或者将它们标记为错误并单独导出以便后续修正。关键是要区分“格式错误”和“数据无效”,前者可以通过调整映射规则解决,后者则需要人工干预或数据清洗。
基于导入结果中日期字段为NULL的具体问题
如果在导入完成后,发现某些日期字段的值为NULL,这通常意味着源数据中的对应单元格为空、包含非日期字符,或者映射规则未能成功解析该值。要解决这个问题,首先需要检查源文件中这些单元格的实际内容。如果单元格确实为空,且数据库允许NULL值,则这是正常现象。如果单元格包含看似有效的日期但依然转为NULL,说明映射规则存在缺陷,需要重新配置转换规则。例如,如果源数据使用“dd/mm/yyyy”格式,而映射规则设置为“mm/dd/yyyy”,在某些情况下会导致解析失败并返回NULL。因此,仔细核对源数据格式与映射规则的匹配度是避免NULL值的关键。