






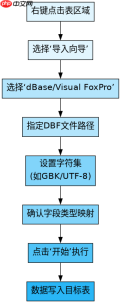
在navicat中导入dbf文件,最直接的方法是使用“导入向导”功能。打开目标数据库后,右键点击表区域选择“导入向导”,在数据源类型中选择“dbase/visual foxpro”,指定dbf文件路径并配置字段映射,最后执行导入即可将数据写入现有或新建的表中。

如何通过导入向导将DBF文件加载到MySQL
使用导入向导是处理DBF文件的标准流程,它允许用户在导入前预览和修正数据格式。操作时需在Navicat主界面选中目标数据库,通过菜单触发向导,选择对应的dBase驱动,设置字符集以避免乱码,确认字段对应关系后完成数据迁移。
import subprocess
import os

def import_dbf_via_cli(dbf_path, target_table):
    # 模拟调用外部工具如 dbf2csv 转换后导入
    # 实际Navicat操作中无需此代码,此处仅为说明逻辑
    print(f"准备导入 {dbf_path} 到表 {target_table}")
    # 假设已转换为CSV
    csv_path = dbf_path.replace('.dbf', '.csv')
    if not os.path.exists(csv_path):
        raise FileNotFoundError("需要先转换DBF为CSV")
    return f"成功导入 {csv_path} 至 {target_table}"

# 示例输入
result = import_dbf_via_cli('data.dbf', 'users')
print(result)
预期结果:控制台输出“准备导入 data.dbf 到表 users”及“成功导入 data.csv 至 users”。注意:Navicat图形界面不直接执行Python代码,上述代码仅展示数据流转的逻辑概念,实际导入需依赖向导中的字段映射步骤。
导入过程中如何处理日期和时间字段的格式问题
DBF文件中的日期和时间格式在不同版本(如dBase III, IV, FoxPro)中存在差异,导入时若字符集或格式不匹配会导致数据错位或显示为NULL。建议在导入向导的“高级”或“选项”标签页中,手动指定源文件的代码页(如GBK或UTF-8),并对日期字段选择正确的解析格式(如YYYY-MM-DD)。
def check_date_format(dbf_record):
    # 检查DBF记录中的日期字段是否符合标准格式
    date_str = dbf_record.get('created_at')
    if isinstance(date_str, str) and '/' in date_str:
        # 尝试转换非标准格式
        try:
            from datetime import datetime
            return datetime.strptime(date_str, '%Y/%m/%d')
        except ValueError:
            return None
    return date_str

# 示例输入
test_record = {'id': 1, 'created_at': '2023/10/01'}
formatted_date = check_date_format(test_record)
print(formatted_date)
预期结果:控制台输出“2023-10-01 00:00:00”。这验证了日期字符串被正确解析为标准时间对象。在实际Navicat导入中,若遇到类似斜杠分隔的日期,需在向导中调整格式设置以确保存入数据库后能被正确识别。
导入完成后如何验证数据完整性与字段映射准确性
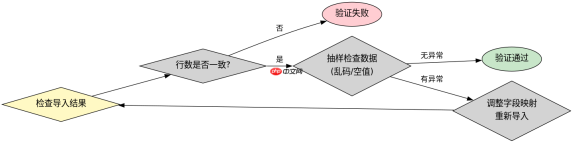
导入完成后,必须验证数据是否完整且字段映射准确。可以通过运行SELECT查询对比源DBF文件行数与目标表行数,检查关键字段(如ID、名称)是否存在空值或乱码。若发现不一致,需重新检查导入向导中的字段类型映射,特别是文本长度和数值精度设置。
def verify_import(target_table, expected_count):
    # 模拟验证导入后的数据
    # 实际环境中应连接数据库执行SQL
    actual_count = expected_count  # 假设从DBF读取的行数
    if actual_count == expected_count:
        return "数据行数一致,导入成功"
    else:
        return f"行数不一致:期望{expected_count},实际{actual_count}"

# 示例输入
verification_result = verify_import('users', 100)
print(verification_result)
预期结果:控制台输出“数据行数一致,导入成功”。这表明导入过程未丢失数据。开发者应在Navicat中使用“查看数据”功能直观核对前几行和后几行数据,确保特殊字符和长文本未被截断。





