在navicat中将查询脚本从一个连接迁移到另一个连接,最稳妥的方法是导出为sql文件后重新导入。具体做法是:在源连接的“查询”节点上右键选择“导出查询”,保存为.sql文件;然后在目标连接的“查询”节点上右键选择“运行sql文件”,选中刚才保存的文件即可。此方法能保留脚本内容、注释及基本格式,且不受navicat版本或连接类型差异的影响。

如何导出单个查询脚本
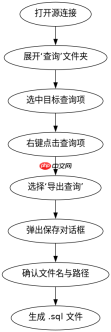
要导出单个查询脚本,需在左侧导航栏中展开源数据库连接,找到“查询”文件夹。在该文件夹下找到需要迁移的特定查询项,右键点击它,在弹出的上下文菜单中选择“导出查询”。在随后出现的文件保存对话框中,选择存储路径并确认文件名,系统会自动生成包含该查询语句的.sql文件。这一步骤确保了只有选定的脚本被提取,避免了批量导出的混乱。
-- 假设这是从源连接导出的查询脚本内容
SELECT * FROM users WHERE status = 'active';
-- 注释部分也会被保留
上述代码展示了导出后的典型内容结构。实际生成的文件不仅包含SQL语句,还会保留用户在Navicat编辑器中添加的注释。执行导出操作时,请确保没有同时选中多个查询,否则可能会触发批量导出功能,导致文件结构不符合预期。若查询中包含特殊字符或中文注释,建议检查编码设置通常为UTF-8,以避免乱码。
如何在目标连接中运行SQL文件
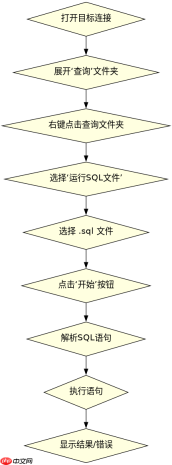
将SQL文件准备好后,切换到目标数据库连接。在左侧导航栏中展开目标连接,右键点击其下的“查询”文件夹,选择“运行SQL文件”。在弹出的文件选择窗口中,定位并选中之前导出的.sql文件。点击“开始”按钮,Navicat会解析文件中的SQL语句并在目标数据库中执行。如果脚本仅包含SELECT语句,结果将直接显示在结果网格中;若包含INSERT、UPDATE等修改语句,则需确认执行权限和事务状态。

Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
-- 在目标连接中运行后的预期结果
-- 如果原脚本是 SELECT * FROM users...
-- 这里将显示目标库中 users 表的数据
运行SQL文件时,Navicat会逐条执行其中的语句。若文件中包含多条语句,它们会被作为一个批次处理。如果在执行过程中遇到错误(如表不存在或权限不足),程序会停止并提示错误信息。此时可以查看错误日志,修正脚本或环境配置后重新运行。对于大型脚本,建议先在测试环境中验证,再在生产环境中执行,以确保数据安全。
导出脚本中是否包含表结构定义
通过“导出查询”功能导出的文件仅包含用户手动编写的查询语句,不包含表结构定义(CREATE TABLE)或数据(INSERT INTO)。若需迁移完整的表结构或数据,应使用“数据传输”或“导出向导”功能。因此,当仅复制查询脚本时,目标库中必须已存在对应的表结构,否则运行查询会报错。这种设计使得查询脚本具有独立性,便于在不同环境的相同表结构间复用逻辑。