






嵌套子查询在大数据量下导致内存不足,核心原因是数据库优化器无法有效将子查询转换为高效的连接操作(如hash join),导致中间结果集在内存中膨胀或产生大量的临时表i/o开销。具体做法是:识别出低效的嵌套结构,将其重写为显式的`join`语句,或者使用`exists`/`in`配合适当的索引,从而让执行计划选择更优的连接算法,减少内存占用。
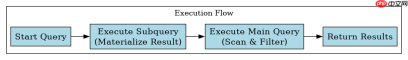
嵌套子查询的执行计划为何低效
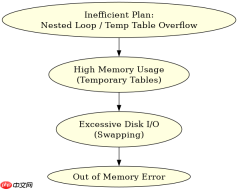
当SQL中包含嵌套子查询时,如果优化器未能将其转换为连接操作,可能会采用“相关子查询”或“非相关子查询”的逐行扫描策略。对于大数据量,这种策略会导致外层表的每一行都要触发一次内层查询,产生巨大的计算量和临时数据缓冲。即使优化器尝试转换,若缺乏合适的统计信息或索引,也可能生成错误的执行计划,导致Hash Join的构建阶段溢出到磁盘,进而引发内存不足错误(OOM)。
SELECT * FROM orders o
WHERE o.customer_id IN (
    SELECT c.id FROM customers c
    WHERE c.region = 'US' AND c.created_at > '2023-01-01'
);
上述代码展示了典型的嵌套子查询场景。在执行时,数据库首先执行子查询获取符合条件的客户ID列表。如果该列表非常大,它可能被存储在内存中的临时表中。随后,主查询遍历`orders`表,检查`customer_id`是否在该列表中。如果内存不足以容纳这个临时列表,数据库会将临时数据交换到磁盘,严重拖慢速度并可能因临时文件空间耗尽而失败。相比之下,使用JOIN可以让数据库利用哈希算法或排序算法更高效地处理连接,且更容易通过索引优化。
如何重写为JOIN以解决内存问题
将嵌套子查询重写为`INNER JOIN`或`LEFT JOIN`是解决此类问题的标准做法。通过显式指定连接条件,优化器可以更清楚地了解数据之间的关系,从而选择更合适的连接算法。例如,将`IN`子查询改为`JOIN`后,数据库可以直接在两个表之间进行匹配,避免了创建大型临时结果集的需要。此外,确保连接列上有索引可以进一步加速这一过程。

SELECT DISTINCT o.* FROM orders o
INNER JOIN customers c ON o.customer_id = c.id
WHERE c.region = 'US' AND c.created_at > '2023-01-01';
这段代码演示了如何将前一个例子中的子查询转换为JOIN。使用`DISTINCT`是为了防止因一对多关系导致的重复行,这与原`IN`子查询的行为一致。在执行计划中,这通常会被转化为一个Hash Join或Nested Loop Join,具体取决于数据分布和索引情况。由于JOIN操作可以直接流式处理数据,而不需要像子查询那样先物化整个子查询结果,因此内存占用显著降低。在实际操作中,应监控执行计划,确保没有发生临时的磁盘交换,并验证查询结果的准确性。
基于特定输入条件下JOIN与子查询的性能差异
当输入数据量极大且存在大量重复值或稀疏索引时,JOIN与子查询的性能差异尤为明显。例如,假设`customers`表中有数百万条记录,而`orders`表有数亿条记录,且`customer_id`在`orders`表上无索引。在这种情况下,子查询可能会先物化所有符合条件的客户ID,然后对每个订单进行查找,导致极高的I/O开销。而JOIN操作则可以利用哈希表在内存中快速构建查找结构,即使内存紧张,也可以通过分块处理来缓解压力。关键在于理解数据分布和执行计划的细节,选择最适合当前场景的重写方式。


