






sql中执行大数据量group by导致内存溢出,核心做法是开启或优化分布式计算引擎的shuffle机制,将数据按key分散到多个节点并行聚合,避免单节点oom。具体而言,需调整`spark.sql.shuffle.partitions`等参数增加并行度,并确保使用支持外存溢出的排序算法(如tungsten)。若数据倾斜严重,还需引入加盐(salting)技术打散key。
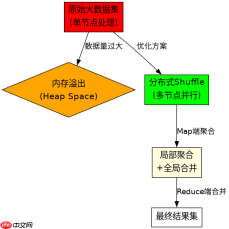
如何配置Spark SQL以支持大规模Shuffle
通过调整`spark.sql.shuffle.partitions`参数,可以将默认较少的分区数增加到数百甚至数千,从而降低每个Task处理的数据量,防止单个Executor内存不足。同时,启用`spark.sql.adaptive.enabled`开启自适应查询执行(AQE),能自动优化Shuffle读取和Join策略。

spark.conf.set("spark.sql.shuffle.partitions", "200")
spark.conf.set("spark.sql.adaptive.enabled", "true")
df.groupBy("key").agg(count("*")).show()
预期结果:任务成功完成,无OOM异常,日志显示Shuffle Read/Write阶段正常进行。
如何处理Group By中的数据倾斜问题
当某些Key对应的数据量远大于其他Key时,会导致个别Task处理数据过多而OOM。解决方法是在Group By前对Key进行加盐操作,即给Key附加随机前缀,将大Key拆分为多个小Key分别聚合,然后再去掉前缀进行二次聚合。
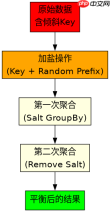
from pyspark.sql.functions import concat, lit, rand
salted_df = df.withColumn("salted_key", concat(lit(rand() * 10).cast("int"), lit("_"), col("key")))
# 第一次聚合
first_agg = salted_df.groupBy("salted_key").agg(count("*").alias("cnt"))
# 第二次聚合
df.groupBy("key").agg(sum("cnt").alias("total_cnt")).show()
预期结果:各Task负载均匀,整体执行时间缩短,无单点OOM。
基于程序中某个输入、条件或结果的具体问题
在加盐聚合场景中,如果原始数据中存在大量Null值的Key,加盐操作可能导致Null值被错误地拆分或丢失。需确保在加盐前过滤或替换Null值,或在二次聚合时正确处理Null Key。


