






SQL Server中聚合查询遭遇巨大TempDB开销该如何调优?
通过添加合适的索引、优化查询语句以及调整数据库配置,可以显著减少sql server中聚合查询的tempdb开销。具体做法包括:确保聚合列上有适当的索引,避免不必要的排序和哈希操作;使用更高效的聚合函数或子查询来减少中间结果集的大小;检查并优化数据库的配置参数,如最大内存设置和并行度限制。
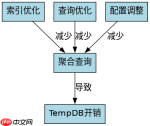
如何选择合适的索引以减少TempDB的使用?
选择合适的索引是减少TempDB使用的关键。对于聚合查询,建议在聚合列上创建覆盖索引,这样可以避免额外的排序和哈希操作。例如,如果经常对`SalesAmount`进行SUM聚合,可以在该列上创建一个包含所有必要字段的非聚集索引。

-- 示例代码:创建覆盖索引
CREATE NONCLUSTERED INDEX IX_Sales_SalesAmount
ON Sales (CustomerID, ProductID)
INCLUDE (SalesAmount);
上述代码创建了一个名为`IX_Sales_SalesAmount`的非聚集索引,它包含了`CustomerID`和`ProductID`作为键列,并且包含了`SalesAmount`作为包含列。这样,当执行聚合查询时,SQL Server可以直接从索引中获取所需的数据,而不需要在TempDB中进行额外的排序或哈希操作。
如何通过优化查询语句来减少TempDB的使用?
优化查询语句也是减少TempDB使用的重要方法。可以通过以下几种方式来优化查询:
- 避免使用SELECT *:只选择需要的列,减少数据传输量。
- 使用EXISTS代替IN:在某些情况下,`EXISTS`比`IN`更高效,因为它可以在找到第一个匹配项后立即停止搜索。
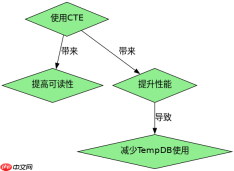
- 使用CTE(公共表表达式):CTE可以提高查询的可读性和性能,特别是在处理复杂的多步骤查询时。
-- 示例代码:使用CTE优化查询
WITH SalesSummary AS (
    SELECT CustomerID, SUM(SalesAmount) AS TotalSales
    FROM Sales
    GROUP BY CustomerID
)
SELECT c.CustomerName, s.TotalSales
FROM Customers c
JOIN SalesSummary s ON c.CustomerID = s.CustomerID;
上述代码使用了一个CTE `SalesSummary`来计算每个客户的总销售额,然后将其与`Customers`表连接以获取客户名称。这种方式不仅提高了查询的可读性,还减少了TempDB的使用,因为CTE可以在内存中高效地处理数据。
在特定条件下,如何进一步减少TempDB的使用?
在某些特定条件下,可以采取进一步的措施来减少TempDB的使用。例如,如果查询涉及大量的数据分组和排序,可以考虑增加服务器的内存资源,以便SQL Server能够更多地使用内存中的工作区而不是TempDB。此外,还可以调整数据库的配置参数,如`max degree of parallelism`(最大并行度),来控制并行查询的执行方式,从而减少TempDB的使用。
-- 示例代码:调整最大并行度
EXEC sp_configure 'max degree of parallelism', 4;
RECONFIGURE;
上述代码将`max degree of parallelism`设置为4,这意味着SQL Server在执行并行查询时将最多使用4个CPU核心。这有助于控制并行查询的资源消耗,从而减少TempDB的使用。


