






在sql中通过单次扫描完成多指标的条件聚合统计,核心是利用聚合函数配合case表达式或布尔值进行条件过滤。具体做法是在select子句中,对需要统计的每个指标编写一个聚合函数(如sum、count),并在其内部包裹一个case when语句来指定筛选条件,或者直接使用支持布尔运算的数据库方言将条件作为参数传入。这样做可以在一次表扫描中同时计算出多个维度的汇总数据,避免多次全表扫描带来的性能损耗。
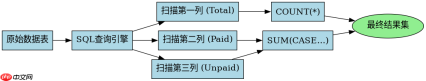
CASE表达式如何实现多条件计数
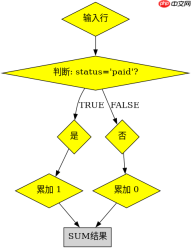
使用标准的CASE WHEN表达式结合COUNT或SUM函数,可以精确控制哪些行被计入特定指标。例如,统计订单总数以及其中已支付和未支付的订单数,只需在SELECT列表中定义三个不同的聚合列,分别对应总记录数和满足特定状态条件的记录数。这种方法兼容所有主流关系型数据库,逻辑清晰且易于维护。
SELECT
  COUNT(*) AS total_orders,
  SUM(CASE WHEN status = 'paid' THEN 1 ELSE 0 END) AS paid_count,
  SUM(CASE WHEN status = 'unpaid' THEN 1 ELSE 0 END) AS unpaid_count
FROM orders;
布尔值直接参与聚合的优势
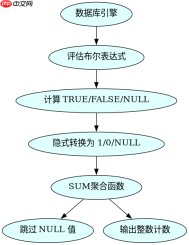
在PostgreSQL、MySQL 8.0+等支持隐式布尔转换的数据库中,可以直接将布尔表达式作为SUM的参数。因为TRUE通常被视为1,FALSE被视为0,所以SUM(condition)等价于统计满足condition的行数。这种写法比CASE表达式更简洁,执行效率在某些优化器下也更高,因为它减少了语法解析的开销。
SELECT
  COUNT(*) AS total_orders,
  SUM(status = 'paid') AS paid_count,
  SUM(status = 'unpaid') AS unpaid_count
FROM orders;
处理NULL值对条件聚合的影响
当条件字段包含NULL值时,CASE表达式中的ELSE分支会捕获这些空值,而布尔比较(如status = 'paid')在遇到NULL时会返回NULL而非FALSE。在SUM函数中,NULL值会被忽略不计入总和,这可能导致统计结果与预期不符。因此,在使用布尔聚合前,需确保数据完整性或使用COALESCE处理空值,以保证统计准确性。


