






sql的row_number排序后出现数据倾斜,根本原因是数据分布不均或排序键(order by)存在大量重复值,导致部分分区处理的数据量远超其他分区。要解决这个问题,需要确保在窗口函数执行前通过增加随机因子打散数据,或者使用全局排序策略避免单点瓶颈。
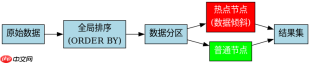
为什么排序会导致数据倾斜?
当使用ROW_NUMBER() OVER (ORDER BY col)时,数据库必须对所有数据进行全局排序。如果col的值分布极不均匀(例如某个值出现百万次),或者数据本身在物理存储上就集中在某些节点,那么负责处理这些“热点”数据的计算节点就会成为瓶颈。此外,如果ORDER BY字段是哈希分区的依据,且该字段区分度低,也会导致数据倾斜。
SELECT
    id,
    name,
    ROW_NUMBER() OVER (PARTITION BY category ORDER BY create_time DESC) as rn
FROM orders;
上述代码中,如果category只有几个值,而每个category下又有海量数据,虽然PARTITION BY缓解了全局排序压力,但如果某个category的数据量极大,仍可能导致单个分区内的排序开销过大。更严重的是,如果ORDER BY后的字段在分区内依然高度集中,局部排序也会产生倾斜。
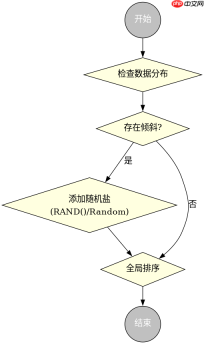
如何通过加盐解决倾斜问题?
引入随机数作为第二排序键是解决倾斜的经典方法。通过在ORDER BY子句中加入RAND()或一个随机生成的整数,可以将原本聚集在一起的数据打散到不同的逻辑组中,从而平衡各节点的计算负载。这种方法适用于对最终排序顺序没有严格唯一性要求的场景,或者在业务允许一定随机性的情况下。
SELECT
    id,
    name,
    ROW_NUMBER() OVER (PARTITION BY category ORDER BY RAND()) as rn
FROM orders;
在这个例子中,我们使用了RAND()作为排序依据。虽然这破坏了基于create_time的业务排序逻辑,但在某些只需要获取“任意一条”或“随机抽样”的场景下非常有效。如果需要保持原有排序逻辑的同时解决倾斜,可以考虑先进行采样分析,识别出倾斜的key,然后对这些key进行特殊处理,比如拆分大key为多个小key进行处理后再合并。
针对特定倾斜Key的具体处理方案
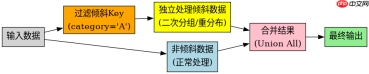
假设我们发现category='A'的数据量是其他类别的10倍,导致处理'A'的节点OOM。我们可以将category='A'的数据单独提取出来,进行二次分组排序,或者使用广播变量关联小表来避免Shuffle。具体做法是:先过滤出倾斜的key,对其执行局部聚合或重分布,再与非倾斜数据Union All。这种针对性处理能显著降低整体作业的运行时间。


