






在sql中使用lag函数构建状态变更追踪流水线,核心做法是利用窗口函数获取上一行记录的状态值,并通过比较当前行与上一行的状态差异来识别变更事件。具体实现时,需按时间或序列对数据排序,调用lag()函数提取前一行字段,随后用case语句判断是否发生跳变,从而标记出有效的状态变更点。

如何确定状态变更的起始时间点
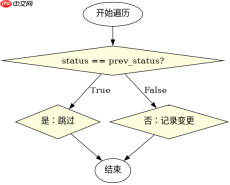
要确定状态变更的起始时间点,必须确保数据按照业务时间顺序严格排列,并使用LAG函数将当前行的状态与前一行进行比对。当发现当前状态不等于前一状态时,该行的时间戳即为变更发生的时刻;若状态相同,则忽略该行,不产生新的变更记录。
SELECT
  id,
  status,
  changed_at,
  LAG(status) OVER (ORDER BY changed_at) AS prev_status
FROM user_activity;
上述查询返回每一行及其对应的上一行状态。通过在外层包裹一层过滤条件WHERE current.status != prev.status,即可精准定位每一次状态变化的具体时间点,形成流水线的输入基础。
如何为连续状态分配唯一批次ID
为连续相同状态的数据分配唯一的批次标识,可以借助LAG函数的结果结合SUM聚合窗口函数实现。每当检测到状态发生变化时,生成一个递增的增量1,否则为0,再对该增量列做累计求和,即可得到每个状态段的唯一Group ID。

WITH base AS (
  SELECT
    id,
    status,
    changed_at,
    LAG(status) OVER (ORDER BY changed_at) AS prev_status
  FROM user_activity
)
SELECT
  id,
  status,
  changed_at,
  SUM(CASE WHEN status != prev_status THEN 1 ELSE 0 END)
    OVER (ORDER BY changed_at) AS batch_id
FROM base;
此代码片段展示了如何将原始流水转化为带批次号的中间表。其中batch_id在每次状态切换时加一,保证同一状态的所有记录拥有相同的ID,便于后续统计持续时长或触发下游逻辑。
基于程序中某个输入、条件或结果的具体问题
当输入数据中存在空值(NULL)状态时,LAG函数默认会将NULL视为有效值参与比较,可能导致误判。例如,若第一行状态为NULL,第二行为'active',系统会认为发生了变更并生成一条记录。为避免此类偏差,应在计算前使用COALESCE将NULL替换为默认占位符,或在比较逻辑中显式处理空值情况。


