






统计特定时间窗口内高频出现的异常ip总数,核心做法是先通过子查询或cte筛选出满足频次阈值的ip,再对结果集进行计数。具体实现时,需明确定义“异常”的判断条件(如状态码、错误日志关键字)以及“高频”的阈值(如出现次数大于n),利用group by和having子句完成过滤,最后使用count函数得出唯一ip的数量。

如何构建基础的时间窗口与异常过滤逻辑
该步骤旨在从海量日志中精准提取出目标时间段内的可疑记录。我们假设数据存储在名为access_logs的表中,需要统计过去1小时内的数据。首先,必须确定时间窗口的起始点,通常使用当前时间减去间隔值。其次,定义什么是“异常”,这里以HTTP状态码为5xx作为示例标准。通过WHERE子句限定时间和状态码,可以大幅减少后续聚合计算的数据量,确保只针对真正的异常流量进行分析。
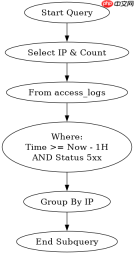
SELECT ip_address, COUNT(*) as error_count
FROM access_logs
WHERE timestamp >= NOW() - INTERVAL 1 HOUR
  AND status_code BETWEEN 500 AND 599
GROUP BY ip_address;
上述查询返回的是每个异常IP及其在指定一小时内的报错次数。这是中间结果,尚未达到“高频”筛选和最终计数的要求。执行此步后,开发者应确认时间格式是否正确解析,以及状态码范围是否覆盖了所有业务定义的异常情况。
如何应用高频阈值并统计唯一IP总数
在获得基础异常列表后,下一步是应用“高频”过滤器。所谓高频,是指某个IP在时间窗口内的异常发生次数超过设定阈值,例如10次。这需要通过HAVING子句对GROUP BY的结果进行二次过滤。筛选出高频IP后,最外层包裹COUNT(DISTINCT ip_address)或直接COUNT(*)(因为分组键已唯一)即可得到总数。这种嵌套结构确保了只有那些真正构成威胁的高频源IP才会被计入最终统计。
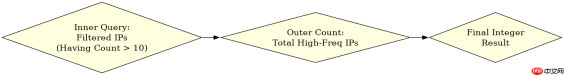
SELECT COUNT(*) as high_freq_abnormal_ip_count
FROM (
    SELECT ip_address
    FROM access_logs
    WHERE timestamp >= NOW() - INTERVAL 1 HOUR
      AND status_code BETWEEN 500 AND 599
    GROUP BY ip_address
    HAVING COUNT(*) > 10
) AS filtered_ips;
该完整SQL语句直接给出了所需的答案。内部子查询负责清洗和分组,外部查询负责计数。运行此代码将返回一个整数,代表在过去一小时内产生超过10次5xx错误的独立IP数量。若结果为0,说明当前无高频异常源;若结果大于0,则表明存在潜在的恶意扫描或服务端集中故障。
当时间窗口边界跨越整点时统计结果有何变化
在实际生产环境中,时间窗口的滑动方式会直接影响统计结果的稳定性。如果使用的是固定窗口(如每小时整点切割),可能会导致分布在两个窗口边界的同一攻击行为被拆分,从而使得单个窗口内的计数低于实际阈值,导致漏报。例如,一个IP在第59分钟和第1分钟各出现6次异常,若按整点切分,两个窗口分别计数为6和6,均未超过10次的阈值,从而未被识别。为解决此问题,通常建议采用滑动窗口或增加重叠时间,或者在业务逻辑上接受这种微小的统计偏差,但在监控告警系统中,固定窗口更易于实现和可视化展示。


