






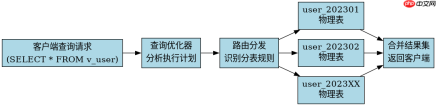
在sql中利用union all构建高性能分表合并视图的核心做法是:直接列出所有物理表的名称,使用union all操作符将它们垂直拼接,并避免在视图定义中使用select * 或复杂的嵌套查询。这样做能确保查询优化器能够直接访问底层索引,实现分区裁剪(partition pruning)或表扫描优化,从而获得接近原生单表查询的性能。若涉及跨库或复杂路由,需配合应用层逻辑或数据库特定的扩展功能。
如何设计基础的分表合并视图结构
基础结构的設計关键在于保持每个子查询的简单性,并确保所有参与UNION ALL的子查询具有完全相同的列顺序和数据类型。通常的做法是为每个分表创建一个独立的SELECT语句,然后将它们串联起来。例如,如果用户表被按月份分成了user_202301、user_202302等表,视图定义应包含对这些表的逐一SELECT。这种结构允许数据库引擎在处理查询时,根据WHERE条件直接定位到特定的分表,而无需扫描所有数据。
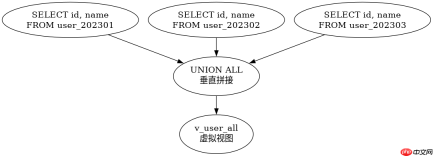
CREATE VIEW v_user_all AS
SELECT id, name, create_time FROM user_202301
UNION ALL
SELECT id, name, create_time FROM user_202302
UNION ALL
SELECT id, name, create_time FROM user_202303;
上述代码展示了最基础的视图创建方式。执行该视图查询时,如SELECT * FROM v_user_all WHERE id = 1001,数据库通常会优化为只查询包含id=1001的那张物理表(如果索引有效),或者全表扫描所有表但无重复数据去重开销。相比UNION,UNION ALL不执行去重操作,因此性能更高,适合分表场景,因为分表数据本身通常是互斥的。
如何处理分表中的元数据与路由条件
在实际应用中,往往需要区分数据来源或添加全局标识。可以在每个子查询中添加一个常量列作为路由标记,或者利用时间范围进行过滤。通过在视图中嵌入简单的CASE表达式或常量赋值,可以增强视图的可读性和调试能力。此外,如果分表数量巨大,手动编写UNION ALL会变得不可维护,此时可考虑使用存储过程动态生成视图,或在应用层组装查询。但在纯SQL视图层面,静态定义仍是主流。
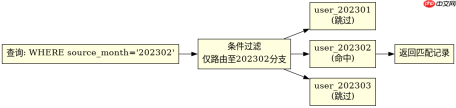
CREATE VIEW v_user_with_source AS
SELECT id, name, '202301' as source_month FROM user_202301
UNION ALL
SELECT id, name, '202302' as source_month FROM user_202302
UNION ALL
SELECT id, name, '202303' as source_month FROM user_202303;
此示例在每个SELECT中添加了source_month字段,便于后续分析数据分布。查询时可直接过滤source_month以加速特定月份的检索。这种写法保持了UNION ALL的高性能特性,同时增加了业务语义。注意,所有子查询的列数必须一致,类型需兼容。
当分表数量超过50个时视图性能会下降吗
当分表数量显著增加时,视图本身的解析和编译开销可能会略微上升,但查询性能主要取决于查询谓词是否能有效下推到具体分表。如果查询条件包含分片键(如user_id或create_time),大多数现代数据库(如MySQL 8.0+、PostgreSQL、TiDB)仍能高效路由。然而,若查询涉及全表扫描且无过滤条件,数据库可能需要遍历所有分表,导致I/O压力增大。此时,建议结合应用层路由或引入物化视图/中间表来缓解压力。



