






使用流式处理避免内存溢出的核心做法是限制并发度并采用背压机制,即通过 spliterator 的 parallel() 方法结合 collectors.tocollection() 或自定义 collector 来分批处理数据。具体实现时,将大数据集转换为并行流,在流中调用异步任务,并使用 forkjoinpool.commonpool().getparallelism() 控制并发线程数,确保同时运行的 completablefuture 数量不超过系统负载能力,从而防止内存溢出。

如何配置并发度以控制资源消耗
通过 ForkJoinPool 限制并发度可以有效控制资源消耗。默认情况下,CompletableFuture 使用公共池,其线程数等于 CPU 核心数。对于高并发场景,建议创建自定义 ForkJoinPool 并传入 CompletableFuture 的 supplyAsync 方法中,以限制同时运行的任务数量。

import java.util.concurrent.*;

public class AsyncExample {
    public static void main(String[] args) throws Exception {
        ForkJoinPool customPool = new ForkJoinPool(4);
        CompletableFuture<string> future = CompletableFuture.supplyAsync(() -> {
            try { Thread.sleep(100); } catch (InterruptedException e) {}
            return "Result";
        }, customPool);
        System.out.println(future.get());
    }
}</string>
如何处理异步任务的异常与结果
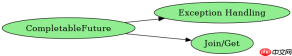
在异步处理中,异常和结果的获取需要特别注意。使用 exceptionally 方法可以捕获异常并返回默认值,而 join 或 get 方法会阻塞直到任务完成。对于批量任务,可以使用 allOf 等待所有任务完成,然后逐个获取结果。

import java.util.concurrent.*;

public class AsyncExample {
    public static void main(String[] args) throws Exception {
        CompletableFuture<string> future = CompletableFuture.supplyAsync(() -> {
            throw new RuntimeException("Error");
        }).exceptionally(e -> "Default");
        System.out.println(future.join());
    }
}</string>
基于 Spliterator 的流式处理如何实现
基于 Spliterator 的流式处理可以通过 StreamSupport.stream() 方法实现。该方法接受一个 Spliterator 和一个 parallel 标志,返回一个并行流。在流中,可以调用 mapAsync 方法(需自定义)来处理每个元素,并使用 collect 方法收集结果。这种方式可以高效地处理大规模数据集,同时保持低内存占用。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


