






java 中通过字符编码序列化传输数据,核心在于将对象转换为字节流时指定正确的字符集(如 utf-8),并在接收端使用相同的字符集还原。具体做法是结合 objectoutputstream 与 outputstreamwriter,或者在基于文本的协议(如 json、xml)中显式设置编码参数。这样做能确保中文等多字节字符在跨平台或网络传输时不发生乱码。

二进制序列化中如何嵌入字符编码处理
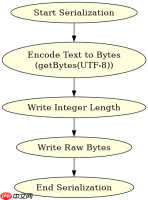
在标准的 Java 对象序列化(Serializable)中,数据直接以二进制格式写入 OutputStream,本身不直接暴露字符编码选择,因为字符串会被序列化为 UTF-8 变长字节序列。但如果需要手动控制字符到字节的转换,例如在自定义协议头中写入长度和文本,必须显式使用 StandardCharsets.UTF_8 进行编解码。这通常发生在混合二进制与文本数据的场景下。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class MixedSerialization {
    public static void main(String[] args) throws Exception {
        String data = "测试数据";
        // 模拟:先写整数长度,再写 UTF-8 字节
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        DataOutputStream dos = new DataOutputStream(baos);

        byte[] bytes = data.getBytes(StandardCharsets.UTF_8);
        dos.writeInt(bytes.length); // 写入长度
        dos.write(bytes);           // 写入原始字节
        dos.close();

        // 读取验证
        ByteArrayInputStream bais = new ByteArrayInputStream(baos.toByteArray());
        DataInputStream dis = new DataInputStream(bais);
        int len = dis.readInt();
        byte[] readBytes = new byte[len];
        dis.readFully(readBytes);
        String result = new String(readBytes, StandardCharsets.UTF_8);
        System.out.println("Result: " + result);
    }
}
上述代码展示了如何在二进制流中安全地嵌入文本。关键点在于 getBytes(StandardCharsets.UTF_8) 和 new String(..., StandardCharsets.UTF_8) 的对称使用。如果发送方使用 GBK 而接收方使用 UTF-8,结果将是乱码。因此,在混合序列化场景中,明确约定并硬编码字符集是避免问题的唯一可靠方式。
文本序列化(JSON/XML)中如何指定编码
对于基于文本的序列化格式,如 JSON 或 XML,字符编码通常在序列化器配置或输出流包装层指定。以 Jackson 库为例,可以通过 JsonFactory 或 ObjectMapper 设置字符集,确保生成的 JSON 字符串符合目标编码要求。这在 HTTP 响应或文件存储中尤为常见。


import com.fasterxml.jackson.databind.ObjectMapper;
import java.io.StringWriter;
import java.nio.charset.StandardCharsets;

public class JsonEncodingExample {
    public static void main(String[] args) throws Exception {
        ObjectMapper mapper = new ObjectMapper();
        String json = mapper.writeValueAsString(new User("张三", 25));

        // 模拟输出到特定编码的 Writer
        StringWriter sw = new StringWriter();
        // 注意:StringWriter 内部使用 Unicode,但可模拟写入 OutputStream
        // 实际应用中常配合 OutputStreamWriter 使用
        byte[] utf8Bytes = json.getBytes(StandardCharsets.UTF_8);
        System.out.println("UTF-8 Bytes Length: " + utf8Bytes.length);
        System.out.println("JSON Content: " + json);
    }

    static class User {
        String name; int age;
        User(String n, int a) { name = n; age = a; }
    }
}
在文本序列化中,虽然 JSON 规范默认推荐 UTF-8,但实际传输时需确保底层 I/O 流(如 OutputStreamWriter)使用一致的编码。Jackson 等库生成的字符串在内存中是 Unicode,最终转为字节时必须指定编码。若使用 ResponseEntity 在 Spring 中返回,需检查 Content-Type 头是否包含 charset=UTF-8,否则客户端可能按默认编码解析导致乱码。
当输入包含特殊字符或空值时序列化行为如何
当输入数据包含 null 值或特殊 Unicode 字符(如 Emoji)时,序列化过程的行为取决于具体实现。对于 ObjectOutputStream,null 字段会被标记为 null,不会抛出异常;对于 JSON 序列化,null 通常转为 JSON 的 null。特殊字符如 Emoji 在 UTF-8 中占 4 字节,若错误地使用单字节编码(如 ISO-8859-1)会导致截断或替换字符。以下代码验证 null 和特殊字符的处理。
import com.fasterxml.jackson.databind.ObjectMapper;
import java.io.*;
import java.nio.charset.StandardCharsets;

public class EdgeCaseSerialization {
    public static void main(String[] args) throws Exception {
        // 测试 1: Null 值
        User userNull = new User(null, 0);
        ObjectMapper mapper = new ObjectMapper();
        String jsonNull = mapper.writeValueAsString(userNull);
        System.out.println("JSON with Null: " + jsonNull);

        // 测试 2: Emoji 字符
        User userEmoji = new User("User?", 30);
        String jsonEmoji = mapper.writeValueAsString(userEmoji);
        byte[] emojiBytes = jsonEmoji.getBytes(StandardCharsets.UTF_8);
        System.out.println("Emoji JSON UTF-8 Length: " + emojiBytes.length);

        // 验证 Emoji 是否正确编码
        String decoded = new String(emojiBytes, StandardCharsets.UTF_8);
        System.out.println("Decoded: " + decoded);
    }

    static class User {
        String name; int age;
        User(String n, int a) { name = n; age = a; }
    }
}
运行结果显示,null 值被正确序列化为 JSON 的 null,而 Emoji 字符在 UTF-8 编码下保持完整。若改用 StandardCharsets.ISO_8859_1 对 Emoji 数据进行编码,decoded 将包含替换字符(),证明编码选择不当会破坏数据完整性。因此,在处理用户输入时,始终优先使用 UTF-8 以兼容所有 Unicode 字符。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


