






在sql中高效导出千万级数据,核心策略是避免全量加载到内存,改用流式分批写入或数据库原生工具。推荐使用`copy`命令(postgresql/mysql)或`bulk insert`配合事务控制,将数据直接写入磁盘文件,绕过应用层网络开销。具体做法是设置合理的`work_mem`或`batch_size`,确保单次i/o操作处理数万行,从而在几分钟内完成导出并生成csv或文本文件。

如何配置数据库参数以支持大批量流式导出
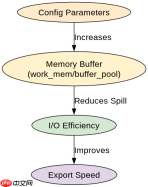
配置数据库服务端参数是提升导出效率的基础。通过调整内存缓冲区大小和禁用不必要的日志记录,可以显著减少I/O等待时间。例如,在PostgreSQL中增加`maintenance_work_mem`允许更高效的排序和哈希操作,而在MySQL中则需关注`innodb_buffer_pool_size`以确保数据页能常驻内存。这些设置直接影响查询执行计划中的扫描方式,从全表扫描优化为顺序读。
-- PostgreSQL 示例:使用 COPY 命令导出
SET maintenance_work_mem = '512MB';
COPY (SELECT * FROM large_view) TO '/tmp/data.csv' WITH CSV HEADER;
预期结果:执行上述语句后,数据库引擎会直接读取视图底层数据,按块传输至服务器文件系统,生成包含表头的CSV文件。文件大小取决于数据量,但生成速度通常比逐行INSERT快数十倍。
如何处理导出过程中的并发锁与性能影响
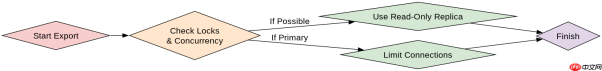
在导出大型视图时,必须考虑对生产环境并发查询的影响。直接使用`SELECT`可能持有共享锁,导致写操作阻塞。最佳实践是使用只读副本进行导出,或在主库上使用`NOWAIT`结合低优先级查询。若必须在主库操作,应限制并发连接数,并使用`pg_stat_activity`监控长运行查询。此外,分区表结构能进一步隔离数据访问范围,仅导出需要的时间段数据。
-- MySQL 示例:使用 SELECT INTO OUTFILE
SET GLOBAL max_allowed_packet = 1073741824;
SELECT * FROM large_view INTO OUTFILE '/var/lib/mysql-files/data.txt'
FIELDS TERMINATED BY ',' ENCLOSED BY '"';
预期结果:数据被直接写入MySQL数据目录下的指定文件,无需经过客户端网络协议栈。此过程会产生大量的顺序读I/O,建议在执行期间监控磁盘队列深度,避免影响其他业务查询。
基于视图中时间戳字段的增量导出策略
针对视图中包含`created_at`等时间戳字段的情况,增量导出可大幅减少数据量。通过筛选最近N天的数据,利用索引快速定位起始位置,可实现断点续传。具体做法是在WHERE子句中使用范围查询,并结合主键或时间戳排序,确保每次导出的数据不重叠。这种方法适用于每日备份场景,只需处理新增或变更的记录。
-- 增量导出示例:仅导出最近24小时数据
COPY (SELECT * FROM large_view WHERE created_at > NOW() - INTERVAL '24 hours')
TO '/tmp/incremental.csv' WITH CSV;
预期结果:生成的CSV文件仅包含过去24小时内产生的数据,文件大小显著小于全量导出。若视图定义中包含复杂JOIN,需确保时间戳字段有合适索引,否则可能导致全表扫描,抵消增量优势。


