






在sql中计算中位数与百分位数的核心方法是使用窗口函数 percent_rank() 或 ntile(),或者利用排序后的行号进行数学推导。具体做法是:先按目标列排序,计算累计百分比或行号排名,再根据总行数定位到对应的中间值。若数据量较大且需精确结果,推荐使用 percent_rank() 配合子查询筛选最接近的值;若只需近似分位,可使用 ntile(100) 将数据切分为百分位桶。

如何使用 PERCENT_RANK 计算精确中位数
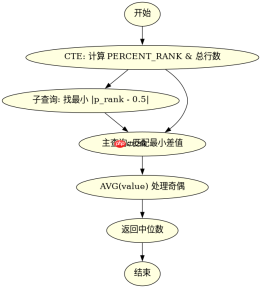
使用 PERCENT_RANK() 可以获取每个值在排序序列中的相对位置(0到1之间)。要得到精确的中位数,需要找出累积概率最接近 0.5 的那一行。如果总行数是奇数,直接取中间值;如果是偶数,则取中间两个值的平均值。这种方法适用于大多数支持标准窗口函数的数据库(如 PostgreSQL, SQL Server, Oracle)。
WITH RankedData AS (
    SELECT
        value,
        PERCENT_RANK() OVER (ORDER BY value) as p_rank,
        COUNT(*) OVER () as total_count
    FROM sales
)
SELECT AVG(value) as median_value
FROM RankedData
WHERE ABS(p_rank - 0.5) = (
    SELECT MIN(ABS(p_rank - 0.5))
    FROM RankedData
);
上述代码首先通过 PERCENT_RANK() 计算每行的相对排名,并通过 COUNT(*) OVER () 获取总行数。外层查询筛选出 p_rank 与 0.5 差距最小的记录,并使用 AVG() 处理偶数行时取平均的情况。注意:在某些数据库中,PERCENT_RANK() 的分母是 N-1,因此最大值可能为 1.0,需确保逻辑覆盖边界情况。
如何使用 NTILE 进行近似百分位分组
当不需要精确到中位数点,而是希望将数据划分为 100 个等份以查看分布时,NTILE(100) 是最直观的选择。它将排序后的数据均匀分成 100 组,每组赋予一个 1 到 100 的桶编号。第 50 组的值即为近似的第 50 百分位数(中位数)。此方法计算速度快,适合大数据集探索性分析。

SELECT
    value,
    NTILE(100) OVER (ORDER BY value) as percentile_bucket
FROM sales;
-- 查询第 50 百分位附近的值
SELECT DISTINCT value
FROM (
    SELECT
        value,
        NTILE(100) OVER (ORDER BY value) as bucket
    FROM sales
) sub
WHERE bucket = 50;
该示例展示了如何将 sales 表中的数据按值排序并分为 100 个桶。子查询为每行分配一个 bucket 编号,外层查询仅保留 bucket = 50 的记录,即代表第 50 百分位区间内的值。由于 NTILE 会尽量均分行数,若总行数不能被 100 整除,各组大小会有微小差异,但结果仍具统计意义。若需更精细的百分位(如 P95),只需将 NTILE(100) 改为 NTILE(20) 并筛选对应桶即可。
当数据存在大量重复值时中位数如何确定
当输入数据中存在大量重复值时,PERCENT_RANK() 和 NTILE() 的行为取决于排序稳定性及重复值的分布。对于 PERCENT_RANK(),相同值会被赋予相同的排名比例,因此在筛选“最接近 0.5”的行时,可能会返回多个相同值的副本,AVG() 仍能正确给出数值结果。对于 NTILE(),重复值可能被分配到不同的桶中,导致同一数值出现在不同百分位区间。此时,若需严格定义中位数,应结合 DENSE_RANK() 或显式去重逻辑,确保重复值不干扰位置计算。


