






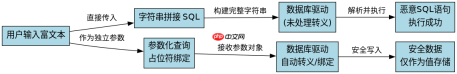
防止富文本内容触发恶意sql注入的核心做法是彻底放弃使用字符串拼接构建sql语句,转而全面采用参数化查询(prepared statements)或orm框架的自动转义机制。在代码实现中,应将用户输入的富文本数据作为独立的参数对象传递给数据库驱动,由底层驱动负责处理特殊字符的转义与类型绑定,从而从根源上隔离数据与指令。若因历史遗留原因必须使用动态拼接,则需对输入进行严格的白名单过滤并调用特定语言的转义函数,但这种方式极易出错且不被推荐。
为什么直接拼接富文本会导致注入
当开发者直接将包含HTML标签或脚本的富文本插入到SQL字符串中时,攻击者可以通过构造特殊的闭合字符来改变SQL语句的逻辑结构。例如,在MySQL中,单引号用于界定字符串,如果富文本中包含未转义的单引号,它可能提前结束当前的字符串字段,进而允许攻击者追加新的SQL命令。这种风险在富文本编辑器中尤为常见,因为用户可能输入包含各种符号的复杂内容,而简单的替换策略往往无法覆盖所有边界情况。
import mysql.connector

def insert_rich_text_bad(db, user_input):
    # 危险:直接拼接用户输入
    query = "INSERT INTO articles (content) VALUES ('" + user_input + "')"
    db.cursor().execute(query)

def insert_rich_text_good(db, user_input):
    # 安全:使用参数化查询
    query = "INSERT INTO articles (content) VALUES (%s)"
    db.cursor().execute(query, (user_input,))
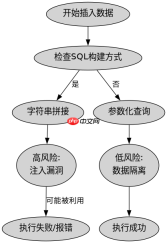
上述代码展示了两种截然不同的处理方式。在`insert_rich_text_bad`函数中,`user_input`被直接拼接到SQL字符串中,如果`user_input`包含类似`'); DROP TABLE users; --`的内容,整个表可能被删除。而在`insert_rich_text_good`函数中,使用了`%s`占位符并将输入作为元组传递,数据库驱动会自动处理转义,确保输入仅被视为数据而非可执行代码。
不同数据库驱动的参数化差异
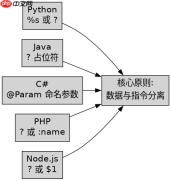
虽然参数化查询是通用解决方案,但不同编程语言和数据库驱动使用的占位符语法存在差异。例如,PostgreSQL通常使用``, ``等位置参数,而SQLite和MySQL常用`?`或`%s`。开发者必须根据具体的技术栈选择正确的占位符格式,并确保参数顺序与占位符一一对应。此外,某些ORM框架如Django ORM或SQLAlchemy会自动处理转义,但在原生SQL查询中仍需显式指定参数。

# Python with psycopg2 (PostgreSQL)
cursor.execute("SELECT * FROM users WHERE name = %s", (user_name,))

# Java with JDBC
cPreparedStatement pstmt = conn.prepareStatement("SELECT * FROM users WHERE name = ?");
pstmt.setString(1, userName);

# C# with SqlClient
SqlCommand cmd = new SqlCommand("SELECT * FROM Users WHERE Name = @Name", connection);
cmd.Parameters.AddWithValue("@Name", userName);
这些示例表明,尽管语法不同,核心原则一致:将数据与SQL结构分离。在Java中,`setString`方法确保了类型安全和转义;在C#中,`AddWithValue`虽然方便,但在处理特定类型时需注意性能开销,推荐使用`Add`方法明确指定类型。无论使用何种语言,都应避免使用字符串格式化操作(如Python的f-string或Java的`String.format`)来构建SQL查询。
富文本中的特殊字符如何处理
富文本内容通常包含大量HTML实体、Unicode字符和特殊符号,这些内容在存入数据库前可能需要经过额外的清洗或编码步骤,但这不应替代SQL参数的使用。例如,存储前的HTML实体编码(如将`


