






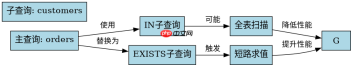
在sql中用exists替代in子查询提升性能,核心在于利用exists的短路求值特性避免全表扫描和笛卡尔积。具体做法是将in子查询改写为相关子查询,并在关联字段上建立索引。这样做能让数据库在执行时一旦找到匹配记录就立即返回,减少i/o开销。
为什么IN子查询在某些场景下性能较差
当主查询数据量大而子查询结果集也较大时,IN子查询可能导致数据库将子查询结果物化为临时表,并进行全表扫描或哈希连接。如果子查询返回NULL值,IN操作会直接导致整个条件失效,因为NULL与任何值的比较结果都是未知。此外,某些数据库优化器对IN的处理不如EXISTS灵活,容易生成低效的执行计划。
SELECT * FROM orders o WHERE o.customer_id IN (SELECT c.id FROM customers c WHERE c.status = 'active');
预期结果:orders表中所有customer_id存在于customers表中且状态为'active'的记录。若customers表中有大量数据,IN子查询可能先执行子查询获取所有ID,再在主表中进行查找,效率较低。
如何用EXISTS改写并验证性能差异
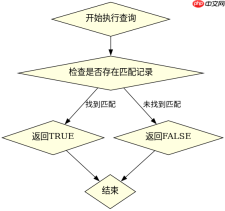
将上述IN子查询改写为EXISTS形式,可以显著提升性能。EXISTS子查询会在找到第一条匹配记录后立即停止搜索,这种“短路”机制在处理大数据量时优势明显。改写后的查询如下:
SELECT * FROM orders o WHERE EXISTS (SELECT 1 FROM customers c WHERE c.id = o.customer_id AND c.status = 'active');
预期结果:与IN子查询相同,但执行计划通常更优。通过EXPLAIN分析,可以看到EXISTS版本往往使用嵌套循环连接,并在找到匹配项后提前退出,而IN版本可能使用哈希连接或合并连接,需要处理更多数据。
基于程序中某个输入、条件或结果的具体问题
当子查询中的关联字段存在NULL值时,IN和EXISTS的行为会有显著差异。例如,如果customers表中某些记录的id为NULL,IN子查询会忽略这些记录,而EXISTS子查询也会正确处理,因为NULL != NULL的比较结果为假。但在某些情况下,如果子查询返回空集,IN条件会变为FALSE,而EXISTS也会返回FALSE,两者行为一致。关键在于确保关联字段上有适当的索引,以支持快速查找。



