






在sql中编写嵌套三层的复杂业务逻辑查询,核心策略是利用cte(common table expressions)或子查询将数据清洗、指标计算和最终聚合分层处理。具体做法是定义三个独立的查询块:第一层负责基础数据的过滤与关联,第二层基于第一层结果进行窗口函数计算或条件汇总,第三层对第二层的结果进行最终的筛选或排序输出。这种结构能显著降低单条语句的复杂度,便于调试每一层的中间结果。
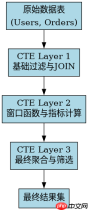
如何设计三层CTE的结构分工
三层CTE的设计应遵循“由粗到细”的逻辑,第一层通常处理原始表的JOIN和基础过滤,第二层处理行级指标计算,第三层处理组级聚合。例如,在处理订单数据时,第一层连接用户表和订单表并过滤掉测试账号;第二层计算每个订单的金额占比;第三层筛选出金额占比超过特定阈值的用户。这种分工使得每层只关注单一职责,避免在FROM子句中堆砌复杂的JOIN条件。

WITH Layer1 AS (
    SELECT
        u.user_id,
        o.order_id,
        o.amount,
        o.created_at
    FROM users u
    JOIN orders o ON u.user_id = o.user_id
    WHERE u.is_test_account = 0
),
Layer2 AS (
    SELECT
        user_id,
        order_id,
        amount,
        SUM(amount) OVER (PARTITION BY user_id) as total_user_amount,
        amount / SUM(amount) OVER (PARTITION BY user_id) as ratio
    FROM Layer1
),
Layer3 AS (
    SELECT
        user_id,
        COUNT(order_id) as high_ratio_order_count
    FROM Layer2
    WHERE ratio > 0.5
    GROUP BY user_id
)
SELECT * FROM Layer3;
上述代码展示了标准的三层结构。Layer1负责数据源准备,Layer2引入窗口函数计算比例,Layer3基于比例进行过滤和计数。运行该查询后,结果集仅包含那些拥有单笔订单金额超过其总消费50%的用户ID及其高占比订单数量。这种写法比将所有逻辑写在一个SELECT中更易读,且各层可独立验证。
如何处理多层嵌套中的性能瓶颈
当三层嵌套涉及大量数据时,性能瓶颈通常出现在第二层的窗口函数或第三层的GROUP BY上。优化方法包括在第一层尽早使用索引过滤减少数据量,以及在第二层避免不必要的重复计算。如果第三层只需要部分字段,确保第二层不返回冗余列。此外,对于极大数据量,可以考虑将CTE物化为临时表,或者检查执行计划是否发生了意外的全表扫描。
-- 假设Layer1已定义
-- 优化后的Layer2:仅选择必要列,避免SELECT *
Layer2_Optimized AS (
    SELECT
        user_id,
        amount,
        -- 直接计算比率,避免存储中间大数
        CAST(amount AS DECIMAL(10,4)) /
        NULLIF(SUM(CAST(amount AS DECIMAL(10,4))) OVER (PARTITION BY user_id), 0) as ratio
    FROM Layer1
),
-- 优化后的Layer3:提前过滤
Layer3_Optimized AS (
    SELECT
        user_id,
        MAX(ratio) as max_ratio
    FROM Layer2_Optimized
    GROUP BY user_id
    HAVING MAX(ratio) > 0.5
)
SELECT user_id, max_ratio FROM Layer3_Optimized;
优化后的代码在Layer2中显式转换数据类型以避免隐式转换开销,并在Layer3中使用HAVING子句直接在聚合阶段过滤,而不是在外部再次WHERE。这减少了数据传输量和内存占用。预期结果是相同的用户列表,但执行时间显著缩短,特别是在用户基数较大时。通过对比执行计划,可以看到优化版减少了Sort和Hash Aggregate的操作成本。
当某一层返回空结果集时如何排查
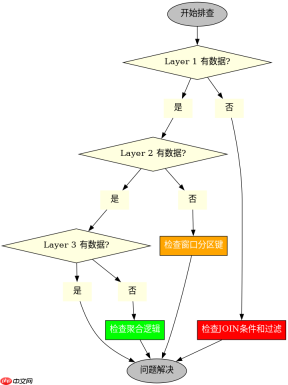
在三层嵌套中,如果最终结果为空,问题可能出在任意一层。排查时应逐层运行CTE,检查每层的输出行数和数据分布。常见原因包括第一层JOIN条件过于严格导致无匹配记录,或第二层窗口分区键错误导致计算偏差。建议为每层CTE添加LIMIT 10查看样例数据,确认逻辑是否符合预期。若某层为空,需回溯上一层的输出,检查过滤条件或关联键是否正确。


