






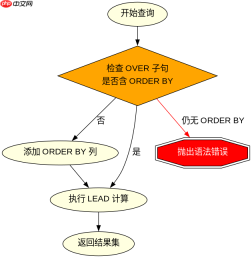
sql中的lead函数在没有order by时报错,是因为窗口函数必须明确定义数据的排序顺序才能计算“下一行”的值。如果不指定order by,数据库无法确定行的逻辑顺序,导致结果不确定或违反语法规范。通常需要在调用lead时显式添加over子句并包含order by子句,例如lead(column_name) over (order by sort_column),这样数据库会按指定列排序后提取后续行的数据。
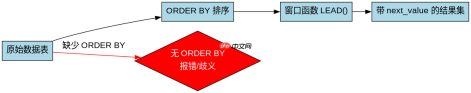
为什么缺少ORDER BY会导致语法错误或逻辑歧义
当开发者尝试使用LEAD等偏移窗口函数但未提供ORDER BY时,大多数现代关系型数据库(如PostgreSQL、SQL Server、Oracle)会直接抛出语法错误,提示必须包含ORDER BY。这是因为窗口函数的核心语义依赖于行的相对位置,而表在磁盘上的物理存储顺序并不等同于业务逻辑上的顺序。如果没有明确的排序规则,数据库引擎无法保证每次查询返回的“下一行”是相同的,这违反了确定性原则。相比之下,LAG和LEAD这类需要前后参照的函数对顺序敏感,因此强制要求排序;而SUM或COUNT等聚合窗口函数若无ORDER BY则仅作为整体聚合处理,行为不同。
-- 正确用法:显式指定排序列
SELECT
    id,
    value,
    LEAD(value) OVER (ORDER BY id) AS next_value
FROM my_table;
上述代码展示了标准写法。通过OVER (ORDER BY id),数据库先根据id列对结果集进行排序,然后逐行计算LEAD值。若省略ORDER BY,如OVER (),在某些数据库中可能被解释为所有行作为一个分区,但此时LEAD的行为未定义或报错,具体取决于数据库实现。为确保兼容性和清晰性,始终应提供ORDER BY。
如何正确处理分区与排序的组合场景
在实际应用中,常需结合PARTITION BY和ORDER BY来限定窗口范围。例如,按用户分组后,在每个组内按时间排序取下一条记录。这种组合能精确控制LEAD的作用域,避免跨组干扰。若仅用PARTITION BY而无ORDER BY,同样会因缺乏内部顺序而引发错误或非预期结果。正确的做法是在OVER子句中同时指定分区键和排序键,确保每个分区内的行有确定的先后次序。

-- 正确用法:分区+排序
SELECT
    user_id,
    event_time,
    LEAD(event_time) OVER (
        PARTITION BY user_id
        ORDER BY event_time
    ) AS next_event_time
FROM events;
此示例中,数据首先按user_id分区,然后在每个分区内按event_time升序排列。LEAD函数仅在同一个用户的事件序列中查找下一个时间点,不会跨越不同用户。这种结构既满足了业务逻辑需求,又符合SQL语法要求。若移除ORDER BY event_time,查询将失败或产生不可靠结果。因此,在处理有序数据时,务必显式声明排序依据。
当最后一行没有后续数据时LEAD返回什么
对于表中最后一行,由于不存在“下一行”,LEAD函数默认返回NULL。这是标准SQL行为,无需额外处理即可安全使用。若希望自定义缺失值,可为LEAD添加第三个参数作为默认值,例如LEAD(value, 1, 'N/A'),这样末行将显示'N/A'而非NULL。这一特性有助于前端展示或后续逻辑判断,避免因空值引发的类型转换问题。理解这一点可帮助开发者编写更健壮的查询语句。


