






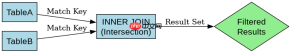
在sql中通过inner join高效实现两表求交集,核心在于利用数据库引擎对join操作进行的索引优化和哈希匹配算法。具体做法是确保参与join的列(通常是主键或外键)上存在合适的索引,并选择适当的连接条件。这样做会返回两个表中连接字段值完全匹配的行集合,从而得到交集结果。
如何构建基础的INNER JOIN查询以获取交集
构建基础INNER JOIN查询时,需要明确指定两个表以及它们之间的关联条件。例如,使用`SELECT * FROM TableA INNER JOIN TableB ON TableA.id = TableB.id`可以获取两表中id相同的记录。这种写法直接利用了关系型数据库的连接逻辑,只要两表在指定列上有相同的数据,就会被包含在结果集中。

SELECT a.id, a.name, b.value
FROM TableA a
INNER JOIN TableB b ON a.id = b.a_id;
上述代码展示了从TableA和TableB中选取特定列的基础查询。假设TableA有id为1, 2, 3的记录,TableB有id为2, 3, 4的记录,那么执行该查询将返回id为2和3的记录,这正是两表的交集部分。注意,如果TableA或TableB中存在重复的id,INNER JOIN会产生笛卡尔积效应,导致结果行数增加,因此在使用前需确认数据唯一性或根据业务需求去重。
如何通过添加WHERE子句进一步过滤交集结果
在INNER JOIN的基础上,可以通过添加WHERE子句来进一步过滤交集结果,以满足更具体的业务需求。例如,除了要求两表id相等外,还可以要求TableA中的某个状态字段为'active'。这样做的结果是只返回满足所有条件的交集记录,提高了数据的精确度。

SELECT a.id, a.name, b.value
FROM TableA a
INNER JOIN TableB b ON a.id = b.a_id
WHERE a.status = 'active';
这段代码在之前的基础上增加了WHERE条件,筛选出TableA中状态为'active'的记录与TableB的交集。如果TableA中id为2的记录状态为'inactive',而id为3的记录状态为'active',那么最终结果将只包含id为3的记录。这种组合查询方式使得开发者能够灵活地控制交集的范围,同时保持查询的高效性,前提是WHERE子句中的列也有相应的索引支持。
当两表数据量巨大时,如何优化INNER JOIN的性能
当两表数据量巨大时,优化INNER JOIN性能的关键在于索引策略和查询结构的调整。首先,确保JOIN条件和WHERE子句中使用的列都有索引,这能显著减少扫描的行数。其次,考虑使用临时表或CTE(公共表表达式)来预处理数据,减少JOIN时的计算量。此外,避免在JOIN条件中使用函数或复杂表达式,因为这会导致索引失效。
例如,如果TableA和TableB各有百万级数据,直接进行INNER JOIN可能会导致全表扫描,性能极差。此时,可以先创建一个包含必要字段的临时表,并对该临时表的JOIN列建立索引,然后再进行JOIN操作。或者,使用EXPLAIN命令分析查询计划,找出瓶颈并进行针对性优化。通过这些方法,可以在大数据量下依然保持INNER JOIN的高效执行。


