






在c#中实现按时间和id排序的键集分页,核心做法是使用`skipwhile`跳过所有小于当前页最后一条记录(即“锚点”)的数据,然后使用`take`获取下一页的数量。具体而言,需要比较时间戳,若时间相同则比较id,确保排序的唯一性和稳定性。这样做可以避免传统偏移量分页在大数据量下的性能问题,并保证数据的一致性。

如何定义用于比较的复合键结构?
为了处理按时间排序时可能出现的重复时间戳,必须引入ID作为第二排序条件。通常的做法是创建一个包含`Timestamp`和`Id`属性的类或结构体,并实现`IComparable`接口以支持自然排序。这样在LINQ查询中可以直接对实体进行比较,或者提取这两个字段组成元组进行排序。
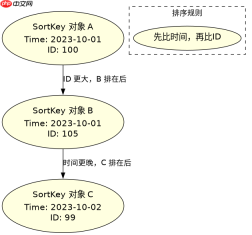
public class SortKey : IComparable<sortkey>
{
    public DateTime Timestamp { get; set; }
    public long Id { get; set; }

    public int CompareTo(SortKey other)
    {
        if (other == null) return 1;
        int cmp = this.Timestamp.CompareTo(other.Timestamp);
        if (cmp != 0) return cmp;
        return this.Id.CompareTo(other.Id);
    }
}</sortkey>
如何在LINQ中编写具体的分页查询逻辑?
在确定了排序键后,具体的分页逻辑可以通过LINQ的`SkipWhile`和`Take`方法组合实现。假设我们有一个已排序的集合`items`,并且已知上一页的最后一条记录的键为`lastKey`,那么下一页的数据就是所有大于`lastKey`的前N条记录。这种方法依赖于内存中的有序集合,适用于缓存数据或小型数据集的分页场景。

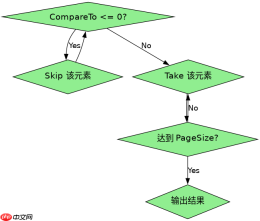
var pageSize = 10;
var lastKey = new SortKey { Timestamp = new DateTime(2023, 10, 1), Id = 100 };

// 模拟已排序的数据源
var items = GetSortedItems();

// 键集分页查询
var nextPage = items
    .SkipWhile(x => x.CompareTo(lastKey) <h2>当数据库不支持直接比较复合键时如何处理?</h2><p>如果数据源是关系型数据库,通常无法直接在SQL层面执行复杂的对象比较。此时需要在SQL层构建等效的WHERE条件。例如,对于MySQL或PostgreSQL,可以编写类似`WHERE (timestamp, id) > (?, ?)`的条件。在C#代码中,这意味着需要手动拼接SQL参数或使用ORM(如Entity Framework Core)的特定语法来生成这种复合条件的查询,以确保利用索引高效定位起始位置。</p>






