






使用 file.readalltext 或 streamreader 并显式指定 encoding.unicode 即可正确读取 utf-16 编码的中文文本文件。utf-16 在 c# 中对应 encoding.unicode,它会处理 bom(字节顺序标记)以自动识别是大端序还是小端序,从而避免乱码。

Encoding.UTF8 与 Encoding.Unicode 的区别是什么
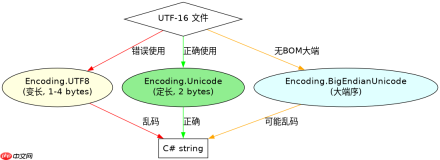
主要区别在于字节表示和 BOM 处理。Encoding.UTF8 是变长编码,每个字符占用 1 到 4 个字节;而 Encoding.Unicode 是固定长度编码(基于 UCS-2/UTF-16LE),每个字符通常占用 2 个字节。如果错误地使用 UTF8 去读 UTF-16 文件,会出现大量乱码或截断。
using System;
using System.IO;
using System.Text;

class Program
{
    static void Main()
    {
        // 假设有一个 UTF-16 LE 编码的文件 test.txt
        string path = "test.txt";

        // 正确读取方式:使用 Encoding.Unicode
        string content = File.ReadAllText(path, Encoding.Unicode);
        Console.WriteLine(content);

        // 错误读取方式演示:使用 Encoding.UTF8
        try
        {
            string wrongContent = File.ReadAllText(path, Encoding.UTF8);
            Console.WriteLine(wrongContent); // 这里通常会显示乱码
        }
        catch (Exception ex)
        {
            Console.WriteLine($"Error: {ex.Message}");
        }
    }
}
预期结果:
1. content 变量包含正确的中文文本。
2. wrongContent 变量包含乱码或异常终止的字符串。

如何处理没有 BOM 的 UTF-16 文件
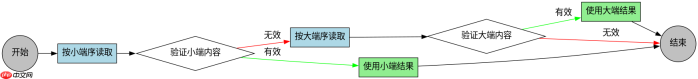
如果文件没有 BOM,Encoding.Unicode 默认假设是小端序(Little-Endian)。如果文件实际上是大端序且无 BOM,读取会出错。此时需要手动指定 Encoding.BigEndianUnicode 或使用 StreamReader 结合 DetectEncodingFromByteOrderMarks 逻辑(但 .NET 标准库不直接支持自动检测无 BOM 的 UTF-16 端序,通常需要业务逻辑判断或尝试两种编码)。
IsChineseValid









