






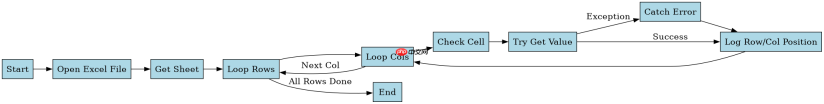
使用npoi库读取excel时,可以通过在循环中捕获特定异常来定位出错的单元格。具体做法是遍历工作表的每一行和每一列,利用try-catch块包裹单元格值的获取逻辑,一旦遇到格式不匹配或空值等导致转换失败的情况,立即记录当前行号和列号,从而精准定位到具体的文件和出错位置。
如何识别Excel文件中的错误数据源
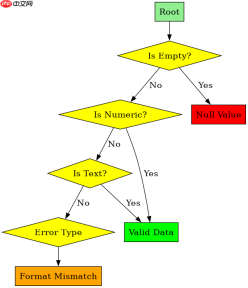
要定位出错单元格,首先需要明确哪些操作会引发异常。在C#中使用NPOI读取Excel时,常见的错误来源包括单元格内容为空、数据类型不匹配(如将文本强制转为数字)以及文件格式损坏。通过检查单元格的类型和状态,可以在读取前过滤掉大部分潜在问题,或者在读取失败时提供更有意义的错误信息。
如何在代码中实现逐单元格错误捕获
为了实现精确的错误定位,需要在遍历工作表时采用嵌套循环结构。外层循环遍历行,内层循环遍历列。在访问每个单元格时,先判断其是否存在,然后尝试获取其值。如果获取值的过程中抛出异常,例如因为单元格包含公式但计算失败,或者类型转换错误,则捕获该异常并记录当前的行索引和列索引。这样就能准确知道是哪个单元格导致了程序中断。

using System;
using System.IO;
using NPOI.SS.UserModel;
using NPOI.XSSF.UserModel;

public class ExcelErrorLocator
{
    public static void LocateErrors(string filePath)
    {
        using (var fs = new FileStream(filePath, FileMode.Open, FileAccess.Read))
        {
            IWorkbook workbook = new XSSFWorkbook(fs);
            ISheet sheet = workbook.GetSheetAt(0);

            for (int rowIdx = 0; rowIdx <p>上述代码展示了基本的错误捕获逻辑。在实际应用中,可以根据需要进一步细化异常处理,例如区分空值异常和类型转换异常。此外,还可以结合Excel的验证规则或条件格式来辅助定位问题单元格。</p><h2>基于程序中某个输入、条件或结果的具体问题</h2><p>当Excel文件中存在大量数据时,逐单元格读取可能会导致性能下降。为了优化这一过程,可以先对工作表进行初步扫描,识别出可能包含错误数据的区域。例如,可以设置一个阈值,当某一行中错误单元格的比例超过一定比例时,标记该行并进行详细检查。这种方法可以减少不必要的异常处理开销,提高整体读取效率。</p>






