






在c#中使用regexoptions.ignorecase时,配合regexoptions.cultureinvariant可以确保大小写比较不依赖于当前线程的区域性设置(culture),从而获得更稳定、跨平台一致且性能更高的匹配结果。默认情况下,正则表达式引擎会遵循特定文化(如土耳其语)的大小写规则,这可能导致意外的匹配失败或成功;而加入cultureinvariant后,引擎将使用unicode标准中的简单二进制映射进行大小写转换,消除了区域性差异。
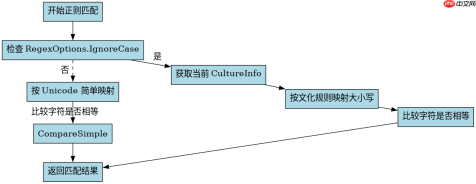
为什么默认IgnoreCase会导致区域性敏感匹配?
默认情况下,RegexOptions.IgnoreCase会使用当前线程的CultureInfo来确定字符的大写和小写形式。在某些语言中,大小写映射并非简单的1对1关系,或者包含特殊的变音符号处理规则。例如,在土耳其语中,小写的ı(无点i)对应大写İ(有点I),而小写的i(有点i)对应大写I(无点I)。如果代码运行在土耳其语环境下,正则表达式[a-z]配合IgnoreCase可能会错误地匹配到非拉丁字母表的字符,或者无法正确匹配预期的ASCII字符。
using System;
using System.Text.RegularExpressions;
using System.Globalization;

class Program
{
    static void Main()
    {
        // 模拟土耳其语环境
        CultureInfo.CurrentCulture = new CultureInfo("tr-TR");

        string pattern = "i";
        string input = "İ"; // 土耳其语大写字母 I-dot

        // 仅使用 IgnoreCase
        bool matchDefault = Regex.IsMatch(input, pattern, RegexOptions.IgnoreCase);
        Console.WriteLine($"Default IgnoreCase: {matchDefault}"); // 可能为 True 或 False 取决于具体实现细节,但在某些上下文中会混淆

        // 使用 IgnoreCase + CultureInvariant
        bool matchInvariant = Regex.IsMatch(input, pattern, RegexOptions.IgnoreCase | RegexOptions.CultureInvariant);
        Console.WriteLine($"CultureInvariant: {matchInvariant}"); // 通常为 False,因为 'i' != 'I' in simple mapping
    }
}
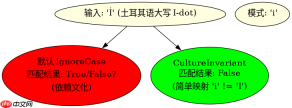
上述代码展示了在土耳其语文化下,i与İ的关系。如果不使用CultureInvariant,正则表达式引擎可能会根据文化规则认为它们相等,从而导致意外匹配。使用CultureInvariant后,引擎只考虑基本的Unicode大小写映射,即i对应I,ı对应İ,从而避免了这种区域性带来的歧义。

如何验证CultureInvariant对性能和安全性的影响?
除了正确性,CultureInvariant还带来性能提升和安全性增强。由于不需要查询当前文化的复杂大小写表,引擎可以直接使用预定义的Unicode数据,速度更快。此外,它减少了因文化设置不同而导致的安全漏洞风险,特别是在处理用户输入时,确保行为一致。

CultureInvariant









