






在sql存储过程中编写高效的树形递归查询,核心在于使用支持递归公用表表达式(cte)的数据库方言(如postgresql、mysql 8.0+、sql server),并通过显式声明路径和深度来避免无限循环。具体做法是定义一个包含锚点成员和递归成员的cte,利用父id关联子节点,并在递归中累积层级信息。若数据量极大或存在环状依赖,需引入访问标记或最大深度限制以优化性能。
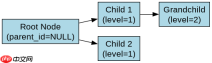
如何构建基础的递归CTE结构
基础结构由两部分组成:锚点查询定位根节点,递归查询连接父子关系。关键在于确保递归部分有终止条件,通常通过检查父ID是否为空或达到指定深度来实现。这种写法能清晰地将树形结构展平为线性结果集,便于后续处理。
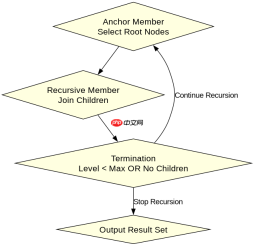
-- PostgreSQL / MySQL 8.0+ 示例
WITH RECURSIVE tree_cte AS (
    -- 锚点成员:查找根节点 (parent_id IS NULL)
    SELECT
        id,
        name,
        parent_id,
        1 AS level,
        ARRAY[id] AS path
    FROM categories
    WHERE parent_id IS NULL

    UNION ALL

    -- 递归成员:查找子节点
    SELECT
        c.id,
        c.name,
        c.parent_id,
        t.level + 1,
        t.path || c.id
    FROM categories c
    INNER JOIN tree_cte t ON c.parent_id = t.id
    WHERE t.level <p>上述代码展示了标准的递归逻辑。`ARRAY[id]`用于记录遍历路径,这在需要判断祖先关系时非常有用。`WHERE t.level </p><h2>如何处理带有环状依赖的数据</h2><p>当数据中存在非法的环状引用时,标准递归CTE会报错或陷入死循环。解决方法是在递归过程中维护一个已访问节点的集合,并在每次递归前检查当前节点是否已在路径中。如果检测到环,则跳过该分支。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/ai/944" title="AI Agent"><img
														src="https://img.php.cn/upload/ai_manual/000/000/000/175679999340073.jpg" alt="AI Agent" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/ai/944" title="AI Agent" class="overflowclass">AI Agent</a>
													<p class="overflowclass">AI Agent是一款用于搭建业务智能体、自动化工作流和团队知识工作台的平台。</p>
												</div>
												<a rel="nofollow" href="/ai/944" title="AI Agent" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/000/969/633/179488065162053.png?x-oss-process=image/resize,p_40" alt="怎么在SQL存储过程中编写高效的树形递归查询"></p><pre class="brush:php;toolbar:false;">-- 带环检测的递归 CTE (PostgreSQL 示例)
WITH RECURSIVE safe_tree_cte AS (
    SELECT
        id,
        name,
        parent_id,
        1 AS level,
        ARRAY[id] AS visited_path
    FROM categories
    WHERE parent_id IS NULL

    UNION ALL

    SELECT
        c.id,
        c.name,
        c.parent_id,
        t.level + 1,
        t.visited_path || c.id
    FROM categories c
    INNER JOIN safe_tree_cte t ON c.parent_id = t.id
    WHERE t.level <p>通过 `NOT c.id = ANY(t.visited_path)` 条件,我们确保了每个节点在同一递归路径中只被访问一次。这有效避免了因环状数据导致的无限递归错误。虽然增加了数组比较的开销,但在大多数业务场景下,这是保证稳定性的必要代价。对于极大规模数据,建议先在应用层清洗数据,去除环状依赖,再使用更简单的递归查询。</p><h2>基于特定输入条件下的性能瓶颈分析</h2><p>在实际运行中,如果某个根节点下的子树极其庞大(例如超过万级节点),递归CTE的性能会显著下降。这是因为每一层递归都需要进行全表扫描或索引查找,且中间结果集不断膨胀。此时,应优先考虑使用闭包表(Closure Table)模式或物化路径(Materialized Path)模式,而非纯递归查询。</p>


