






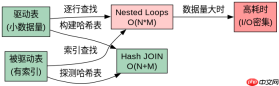
sql执行计划中nested loops比hash join更耗时,通常是因为nested loops在驱动表数据量较大或关联条件选择性较差时,会产生大量的i/o操作和cpu计算开销。具体做法是:当驱动表返回n行,被驱动表每行需要m次查找时,总复杂度为o(n*m),而hash join通过构建哈希表将复杂度降低至接近o(n+m)。若发现nested loops耗时过高,应检查是否缺少索引、统计信息是否过期,或考虑强制使用hint提示优化器选择hash join。
为什么Nested Loops在小数据量下表现更好
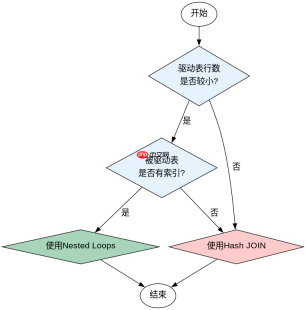
Nested Loops在小数据量下表现更好,因为其启动成本低且无需额外内存空间。它逐行处理驱动表记录,对每一行去被驱动表中查找匹配项,适合被驱动表有高效索引的情况。此时,即使存在多次查找,单次查找成本极低,总体开销小于Hash JOIN的建表与探测阶段。
SELECT /*+ USE_NL(a b) */ a.id, b.name FROM table_a a, table_b b WHERE a.id = b.a_id;
预期结果:当table_a仅返回少量行(如10行),且table_b.a_id上有唯一索引时,执行计划显示Nested Loops,总成本低于Hash JOIN。若table_a返回10万行,则Nested Loops成本显著上升,可能触发全表扫描或大量随机I/O。
什么情况下Hash JOIN会优于Nested Loops
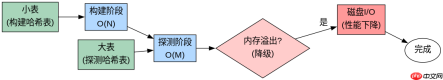
Hash JOIN在大数据量连接时优于Nested Loops,因为它先将小表加载到内存构建哈希表,再扫描大表进行探测,避免了重复查找。其优势在于将时间复杂度从乘积级降至线性级,尤其适用于无索引或索引失效的场景。但需注意内存限制,若哈希表过大导致溢出到磁盘,性能反而下降。
SELECT /*+ USE_HASH(a b) */ a.id, b.name FROM table_a a, table_b b WHERE a.id = b.a_id;
预期结果:当table_a和table_b均为百万级数据且无有效索引时,Hash JOIN通过内存哈希构建实现快速匹配,执行时间远低于Nested Loops。若内存不足,数据库可能自动降级为Merge Join或Nested Loops,需监控PGA/SGA使用情况。
基于程序中某个输入、条件或结果的具体问题
当程序传入的参数导致统计信息陈旧时,优化器可能错误选择Nested Loops。例如,若table_a的最新行数未更新,优化器低估其规模,仍按小表策略选择Nested Loops,造成实际运行时性能骤降。解决方法是手动收集统计信息或使用动态采样,确保执行计划准确反映数据分布。


