






在生产代码中应禁止使用 natural join,因为它会基于所有同名列自动进行等值连接,这种隐式行为极易因表结构变更导致数据泄露或逻辑错误。正确的做法是始终使用显式的 on 子句指定连接条件,确保连接的列名和逻辑完全可控。
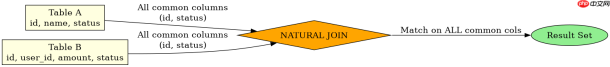
NATURAL JOIN 的隐式匹配机制是什么
NATURAL JOIN 的核心隐患在于它会自动查找两张表中名称完全相同的列作为连接键。如果这两张表除了预期的业务主键外,还存在其他同名的冗余字段(如 id、created_at 或 status),数据库会将这些列也加入连接条件。这意味着只有当这些额外列的值也完全一致时,行才会被连接,这通常会导致意外的结果集缩小甚至为空。
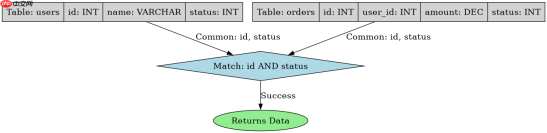
CREATE TABLE users (id INT, name VARCHAR(50), status INT); CREATE TABLE orders (id INT, user_id INT, amount DECIMAL, status INT); -- 危险:自动匹配 id 和 status INSERT INTO users VALUES (1, 'Alice', 1); INSERT INTO orders VALUES (1, 1, 100.0, 1); SELECT * FROM users NATURAL JOIN orders;
预期结果:返回一行,因为 id=1 且 status=1 均匹配。若将订单的 status 改为 0,则结果为空,尽管 user_id 正确关联了用户。
表结构变更如何破坏 NATURAL JOIN 的稳定性
在开发过程中,表结构的微小调整即可彻底破坏依赖 NATURAL JOIN 的查询逻辑。例如,若在 orders 表中新增一个名为 name 的列用于存储订单备注,而 users 表中也有 name 列,NATURAL JOIN 会突然增加对 name 列的匹配要求。此时,除非订单备注与用户名完全一致,否则查询将失败。这种“静默”的逻辑断裂是生产事故的高发区,因为代码本身无需修改即可编译通过,但运行时数据却变得不可信。
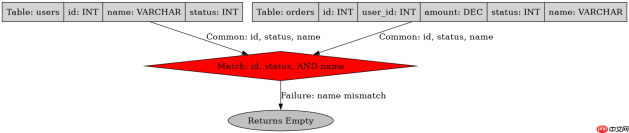
-- 假设 orders 表新增了 name 列 ALTER TABLE orders ADD COLUMN name VARCHAR(100); -- 原有查询失效,因为 orders.name 与 users.name 几乎不可能相等 SELECT * FROM users NATURAL JOIN orders;
预期结果:查询返回空集,即使业务上应该返回所有订单。这是因为 NATURAL JOIN 现在要求 users.name = orders.name,这是一个极难满足的条件。
如何重构为安全的显式连接
解决此问题的唯一可靠方法是弃用 NATURAL JOIN,改用带有明确 ON 子句的 JOIN。开发者需要手动指定连接条件,例如 ON users.id = orders.user_id。这样,即使表中存在其他同名列,也不会影响连接逻辑。这种写法虽然代码量稍多,但清晰表达了开发者的意图,且对表结构的后续变更具有极强的鲁棒性。
SELECT u.name, o.amount FROM users u JOIN orders o ON u.id = o.user_id WHERE u.status = o.status; -- 显式指定 status 比较,而非自动匹配
预期结果:无论表中是否存在其他同名列,只要 id 和 user_id 匹配,且 status 按业务逻辑比较,结果即稳定。这是生产环境推荐的标准实践。


