






在 sql server 2019 中,使用 row_number() 优化分页的核心做法是结合 order by 和 between(或范围比较)来精确提取目标页数据。具体而言,你需要计算当前页的起始行号与结束行号,并在子查询中为结果集分配行号,外层查询再根据这些行号进行过滤。这样做可以避免全表扫描或昂贵的排序操作溢出到磁盘,确保每次只加载当前页所需的数据量。

如何构建基于 ROW_NUMBER 的分页查询结构
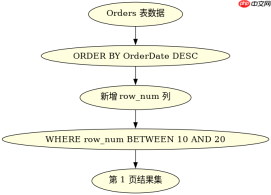
构建该查询结构的关键在于将行号生成与最终过滤分离。首先在一个子查询中使用 ROW_NUMBER() OVER (ORDER BY [排序列]) 为每一行生成唯一序号,然后在外部查询中通过 WHERE row_num BETWEEN @StartRow AND @EndRow 截取指定范围。这种结构能明确控制返回的行数,防止内存溢出。
SELECT * FROM (
    SELECT
        *,
        ROW_NUMBER() OVER (ORDER BY OrderDate DESC) AS row_num
    FROM Orders
) AS PagedResults
WHERE row_num BETWEEN 10 AND 20;
上述代码展示了基本结构。输入为 Orders 表,期望得到第 1 页(假设每页 10 条)的数据。执行时,SQL Server 会先对 OrderDate 进行排序并生成行号,然后仅返回行号在 10 到 20 之间的记录。注意,如果 ORDER BY 的列没有索引,排序过程可能会消耗较多 CPU 和内存资源。
如何处理主键冲突导致的排序不稳定
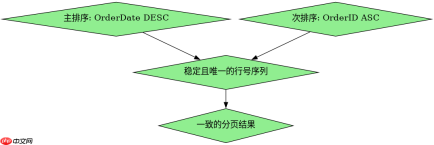
当 ORDER BY 指定的列存在重复值时,ROW_NUMBER() 的排序结果可能是不确定的,导致翻页时数据重复或遗漏。解决此问题的方法是在 OVER 子句中添加一个唯一列(如主键)作为次要排序条件。这样可以确保每一行的行号是绝对稳定且可预测的。
SELECT * FROM (
    SELECT
        *,
        ROW_NUMBER() OVER (ORDER BY OrderDate DESC, OrderID ASC) AS row_num
    FROM Orders
) AS PagedResults
WHERE row_num BETWEEN 10 AND 20;
在此示例中,我们引入了 OrderID 作为第二排序条件。即使 OrderDate 相同,OrderID 的唯一性也能保证排序顺序一致。这对于需要用户反复翻动同一页或从中间页跳转的场景至关重要,确保了数据的一致性体验。
当 ORDER BY 列无索引时性能如何变化
如果 ORDER BY 涉及的列没有建立索引,SQL Server 必须在内存中进行临时排序。当数据量较大时,这会触发 TempDB 磁盘写入,显著降低分页查询速度。此时,优化方向应转向为排序列创建覆盖索引,或者考虑使用更现代的 OFFSET FETCH 语法(在 SQL Server 2012+ 支持),但 ROW_NUMBER 在复杂排序逻辑下仍具优势。


