






兼顾高并发sql批量更新性能与安全的核心做法是:使用预编译语句(preparedstatement)防止注入,通过分批提交控制事务大小以维持连接池稳定,并利用数据库层面的原子性操作或乐观锁机制保证数据一致性。具体实现时,应将大批量数据拆分为固定大小的批次(如500条),在单个事务内执行批量插入或更新,同时确保主键或唯一索引的完整性以避免冲突。
如何防止SQL注入并提升批量处理效率
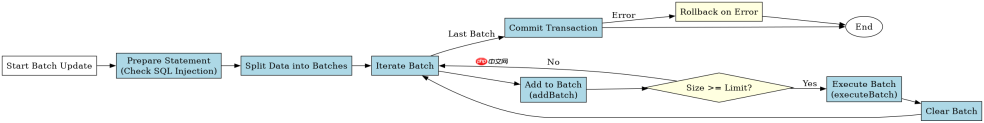
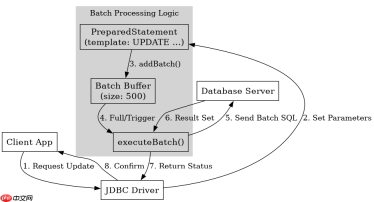
防止SQL注入的最有效手段是使用预编译语句,而提升批量效率的关键在于利用数据库驱动提供的批量执行特性。在Java中,这通常意味着使用PreparedStatement配合addBatch()和executeBatch()方法。这种方式不仅将SQL模板与数据分离,从根本上杜绝了注入风险,还允许驱动程序将多条SQL指令打包发送给数据库,减少网络往返次数。
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.util.List;

public class BatchUpdater {
    private static final int BATCH_SIZE = 500;

    public void updateRecords(Connection conn, List<string> data) throws Exception {
        String sql = "UPDATE users SET status = ? WHERE id = ?";
        // 关闭自动提交,手动管理事务以保证原子性和性能
        conn.setAutoCommit(false);

        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            for (int i = 0; i <p>上述代码展示了标准的批量更新模式。首先,通过<code>setAutoCommit(false)</code>关闭自动提交,将所有更改纳入一个事务中。接着,使用<code>PreparedStatement</code>定义SQL模板,并通过循环调用<code>addBatch()</code>添加参数。当累积到<code>BATCH_SIZE</code>(例如500)时,调用<code>executeBatch()</code>执行并提交当前批次,随后<code>clearBatch()</code>清空缓冲区。这种策略既利用了预编译的安全性,又通过分批执行避免了单次事务过大导致的锁竞争和内存压力。最后,在成功完成后调用<code>conn.commit()</code>,若发生异常则回滚,确保数据一致性。</p>
<h2>如何处理高并发下的数据冲突与锁竞争</h2>
<p>在高并发场景下,批量更新容易引发行锁竞争甚至死锁。解决这一问题的最佳实践是采用乐观锁机制,即在数据表中增加一个版本号字段(如<code>version</code>)。每次更新时,不仅检查业务条件,还检查版本号是否与读取时一致。如果一致则更新并递增版本号,否则拒绝更新并重试。这种方法避免了长时间持有排他锁,提高了并发吞吐量。</p>
<p><img src="https://img.php.cn/upload/article/000/969/633/179487789597349.png?x-oss-process=image/resize,p_40" alt="在编写高并发SQL批量更新时如何兼顾性能与安全"></p>
<pre class="brush:php;toolbar:false;">import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;

public class OptimisticBatchUpdater {
    private static final int MAX_RETRIES = 3;

    public boolean updateWithOptimisticLock(Connection conn, int userId, String newStatus) throws SQLException {
        String selectSql = "SELECT status, version FROM users WHERE id = ? FOR UPDATE";
        String updateSql = "UPDATE users SET status = ?, version = version + 1 WHERE id = ? AND version = ?";

        int retryCount = 0;
        while (retryCount  0) {
                    conn.commit();
                    return true; // 更新成功
                } else {
                    conn.rollback();
                    retryCount++; // 版本冲突,重试
                }
            }
        }
        return false; // 超过最大重试次数
    }
}
该示例演示了乐观锁在单条记录更新中的应用,可推广至批量处理的每个批次中。核心逻辑在于“先读后写”并附带版本校验。SELECT ... FOR UPDATE用于获取当前行的最新状态和版本号(注意:在某些数据库中,FOR UPDATE会加排他锁,若追求更高并发可使用无锁的SELECT+WHERE version=?方式)。更新语句中增加了AND version = ?条件,只有当数据库中的版本号与预期一致时,更新才会生效,且版本号自动加1。如果executeUpdate()返回0,说明在此期间有其他事务修改了该行,导致版本不匹配。此时程序捕获此情况,进行回滚并增加重试计数。这种机制确保了最终一致性,同时避免了因长时间锁定行而导致的其他请求阻塞。
批量更新失败时的数据一致性保障策略
当批量更新过程中部分数据成功、部分失败时,如何保证整体数据的一致性是一个关键问题。最稳妥的策略是实现“幂等性”设计,即无论执行多少次,结果都相同。结合事务的回滚机制,可以在应用层构建一个补偿逻辑。如果整个批次的事务未能完全提交,系统应能够识别出哪些记录已更新,并在下次重试时跳过或重新处理,确保不会重复更新或遗漏。
在实际操作中,可以通过引入一个中间状态表或日志表来记录每次批量更新的进度。例如,在处理前,先将所有待更新记录的ID标记为“处理中”,更新成功后标记为“已完成”,失败则标记为“失败”。这样即使程序崩溃,重启后也能根据日志表的状态决定是继续处理还是回滚。此外,对于非核心数据的批量更新,可以考虑使用异步消息队列(如Kafka)解耦更新操作,将批量任务分解为独立的消息,由消费者逐个处理并确认,从而提供更细粒度的错误处理和重试能力。



