






在postgresql中正确配置last_value窗口帧的核心做法是将窗口子句从默认的range between unbounded preceding and current row显式修改为range between unbounded preceding and unbounded following。默认行为导致该函数只返回当前行之前的最后一个值,而修改后它能跨越整个分区获取真正的末尾数据。这一调整解决了因帧范围限制导致的逻辑错误。
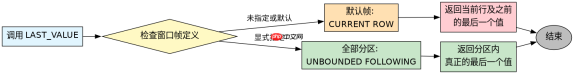
为什么LAST_VALUE默认行为不符合预期
LAST_VALUE函数在PostgreSQL中的默认窗口帧是RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW。这意味着在处理每一行时,函数只能看到从分区开始到当前行的数据。如果目标数据位于当前行之后,函数将无法访问它,从而返回错误的中间结果。这种设计通常适用于累积计算,但不适用于需要获取分区最终状态的查询。
SELECT
    id,
    value,
    LAST_VALUE(value) OVER (
        PARTITION BY category
        ORDER BY id
    ) AS default_last_value,
    LAST_VALUE(value) OVER (
        PARTITION BY category
        ORDER BY id
        RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
    ) AS fixed_last_value
FROM items;
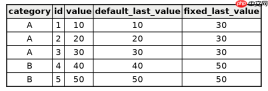
上述代码展示了两种写法的对比。第一列default_last_value使用了默认帧,第二列fixed_last_value使用了修正后的帧。输入数据包含两个类别,每个类别有多行记录。运行结果显示,默认写法在每行返回的是截至该行的最新值,而修正写法在所有行都返回该类别的最终值。
如何显式指定正确的窗口帧
要确保LAST_VALUE获取分区内的最后一个值,必须在OVER子句中明确指定RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING。这告诉数据库引擎在计算时考虑分区内的所有行,而不仅仅是当前行及之前的行。这种显式声明消除了歧义,保证了结果的准确性。
SELECT
    id,
    value,
    LAST_VALUE(value) OVER (
        PARTITION BY category
        ORDER BY id
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
    ) AS row_based_last_value
FROM items;
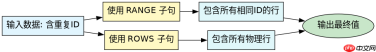
除了RANGE,还可以使用ROWS子句来实现相同的效果。ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING基于物理行数进行界定,而不是基于值的逻辑范围。当存在重复的排序键时,ROWS和RANGE的行为会有所不同,但在此场景下两者都能正确获取最后一个值。开发者应根据数据分布和性能需求选择合适的子句。
处理重复排序键时的帧边界问题
当ORDER BY字段存在重复值时,RANGE和ROWS子句对帧边界的定义会产生差异。RANGE会将所有与当前行具有相同排序键值的行视为同一组,并包含在帧内。而ROWS则严格基于物理行号。如果希望获取严格意义上的最后一行,即使有重复值也需确保帧覆盖所有相关行,此时ROWS子句可能更直观,但需注意其依赖于行的物理顺序。


