






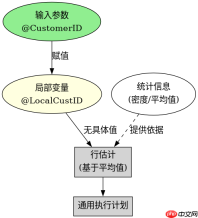
在sql server中解决参数嗅探导致存储过程变慢的核心方法是使用局部变量进行解耦,即在存储过程内部将输入参数赋值给局部变量,并基于这些局部变量构建查询条件。这种做法会强制优化器使用统计信息的平均值(密度向量)来估算行数,从而生成一个对大多数情况都适用的“通用”执行计划,避免了因特定极端参数值导致的索引扫描或错误的连接算法。如果业务场景中存在明显的数据倾斜,还可以结合`option (recompile)`提示,让每次执行都针对当前具体参数重新编译计划,以获取最优的精确估计。

为什么传入的参数会导致执行计划偏离预期
参数嗅探发生在存储过程第一次被编译时,优化器会捕获当时传入的具体参数值,并据此计算行估计值(Row Estimate)。如果首次调用的参数是极端值(例如极多或极少),优化器可能会选择次优的执行策略,如全表扫描而非索引查找,或者选择嵌套循环而非哈希匹配。后续调用即使传入不同的参数,只要复用了这个缓存的计划,性能就会持续低下。
-- 存在参数嗅探风险的原始写法
CREATE PROCEDURE GetOrdersByCustomer
    @CustomerID INT
AS
BEGIN
    -- 直接使用输入参数作为过滤条件
    SELECT OrderID, OrderDate, TotalAmount
    FROM Orders
    WHERE CustomerID = @CustomerID
      AND OrderDate >= '2023-01-01';
END;
在上述代码中,如果第一次调用 `GetOrdersByCustomer(1001)` 时,客户1001有10万条订单,优化器可能认为返回大量数据更划算,从而选择聚集索引扫描。当第二次调用 `GetOrdersByCustomer(9999)` 时,虽然客户9999只有1条订单,但系统依然复用之前的扫描计划,导致响应时间从毫秒级飙升到秒级。
如何通过局部变量隔离参数影响
通过引入局部变量,我们切断了输入参数与查询谓词之间的直接联系。优化器在编译阶段无法得知局部变量的具体值,因此它只能依据列的统计信息(如平均密度)来估算行数。这通常能产生一个更稳健、更通用的执行计划,适合处理混合负载。


-- 使用局部变量解耦后的写法
CREATE PROCEDURE GetOrdersByCustomer_Safe
    @CustomerID INT
AS
BEGIN
    DECLARE @LocalCustID INT;
    SET @LocalCustID = @CustomerID;

    -- 使用局部变量进行过滤
    SELECT OrderID, OrderDate, TotalAmount
    FROM Orders
    WHERE CustomerID = @LocalCustID
      AND OrderDate >= '2023-01-01';
END;
这种写法确保了无论传入什么参数,执行计划都是基于“平均”情况生成的。对于大多数中等数据量的场景,这足以解决严重的性能抖动问题。需要注意的是,如果数据分布极度不均匀且对性能要求极高,局部变量法可能会导致某些极端查询变慢,此时应结合下一节的动态编译方案。
当数据倾斜严重时如何获取精确执行计划
如果局部变量法导致某些特定参数的查询变慢,说明“通用”计划不再适用。此时可以使用 `OPTION (RECOMPILE)` 提示。这会告诉SQL Server在每次执行该语句时都重新编译计划。由于此时优化器能看到具体的参数值,它可以生成针对当前参数的最优计划,彻底消除参数嗅探的影响,代价是增加了CPU编译开销。
-- 结合局部变量与动态编译的终极写法
CREATE PROCEDURE GetOrdersByCustomer_Optimal
    @CustomerID INT
AS
BEGIN
    DECLARE @LocalCustID INT;
    SET @LocalCustID = @CustomerID;

    SELECT OrderID, OrderDate, TotalAmount
    FROM Orders
    WHERE CustomerID = @LocalCustID
      AND OrderDate >= '2023-01-01'
    OPTION (RECOMPILE); -- 强制每次重新编译
END;
在这种模式下,当传入 `@CustomerID = 1001` 时,优化器知道要查10万行,可能选择扫描;当传入 `@CustomerID = 9999` 时,优化器知道只查1行,会选择索引查找。虽然每次都有编译成本,但在现代SQL Server版本中,对于复杂查询,这种收益通常远大于编译开销。建议仅在确实存在严重数据倾斜且前两种方法无效时使用此方案。


