






利用sql中的length函数筛选字符长度异常的数据,核心思路是将目标字段的长度与预期标准或统计分布进行比对。通常通过设置具体的阈值(如最大/最小值)或计算均值与标准差来识别偏离正常范围的值。例如,若已知某字段长度应在10到20之间,可直接使用where length(col) 20;若需基于数据分布动态判断,可结合子查询获取平均长度和标准差,筛选出超出两倍标准差的记录。

如何基于固定阈值筛选长度异常数据
当业务规则明确定义了字符长度的合法区间时,最直接的方法是使用比较运算符配合LENGTH函数。假设我们有一个用户表users,其中email字段理论上应为5-50个字符。我们可以编写查询语句,找出所有长度小于5或大于50的记录。这种方法简单高效,适用于有明确规范的场景。执行该查询后,数据库会返回所有不符合长度约束的行,便于后续人工核查或自动修正。
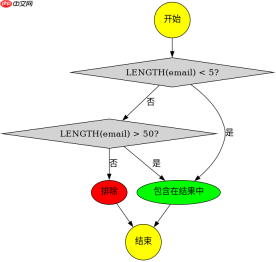
SELECT id, email, LENGTH(email) as len
FROM users
WHERE LENGTH(email)  50;
上述代码在MySQL中运行,输入为包含不同长度email的users表。预期结果是返回那些email过短或过长的行,并附带其实际长度。注意,LENGTH函数在MySQL中按字符计数,若涉及多字节字符集需注意区分CHAR_LENGTH。此外,NULL值的LENGTH结果为NULL,不会出现在结果中,如需包含需额外处理IS NULL条件。
如何基于统计分布识别长度异常值
在没有固定阈值但希望发现统计意义上的异常值时,可采用均值与标准差方法。首先计算字段长度的平均值和标准差,然后筛选出长度偏离均值超过两倍标准差的记录。这有助于捕捉那些虽未违反硬性规则但显著偏离大多数数据的条目。例如,对orders表的address字段进行分析,先求出平均长度avg_len和标准差std_len,再选出LENGTH(address) > avg_len + 2*std_len 或
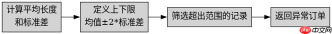
WITH stats AS (
  SELECT AVG(LENGTH(address)) as avg_len,
         STDDEV(LENGTH(address)) as std_len
  FROM orders
)
SELECT o.id, o.address, LENGTH(o.address) as len
FROM orders o, stats s
WHERE LENGTH(o.address) > s.avg_len + 2 * s.std_len
   OR LENGTH(o.address) <p>此CTE结构在PostgreSQL或MySQL 8.0+中有效。输入为orders表,输出为地址长度极端偏离均值的订单ID及地址。需注意,STDDEV函数在某些数据库中可能命名为STDDEV_SAMP或STDDEV_POP,应根据具体环境调整。另外,若数据呈偏态分布,该方法可能误判较多,建议结合箱线图或其他稳健统计量辅助判断。</p><h2>LENGTH函数在处理空字符串和NULL时的行为差异是什么</h2><p>在利用LENGTH函数筛选时,必须区分空字符串''和NULL值,因为它们的处理方式完全不同。空字符串的长度为0,会被LENGTH('')返回0,因此参与数值比较;而NULL的长度也为NULL,任何与NULL的比较结果都是UNKNOWN,导致该行被过滤掉。例如,在查询中若未显式处理NULL,长度为NULL的字段将不会被纳入异常检测范围,可能造成遗漏。若希望将NULL视为异常,需单独添加IS NULL条件。这一细节在实际应用中极易被忽视,却直接影响筛选结果的完整性。</p>


