






在postgresql中,使用 count(*) over (partition by ...) 窗口函数可以直接统计分组总行数。只需将聚合逻辑包裹在窗口函数中并指定分区列,即可在不丢失明细行的情况下获取每组的总数。

COUNT(*) 与 COUNT(1) 的性能差异
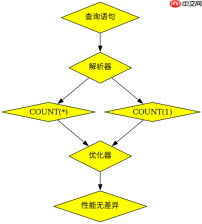
在PostgreSQL中,COUNT(*) 和 COUNT(1) 的执行计划完全一致,性能没有区别。优化器会将它们统一处理为全表扫描计数,因此无需纠结选择哪一个。
SELECT id, name, COUNT(*) OVER () AS total_rows FROM users;
结合 ORDER BY 实现累计统计
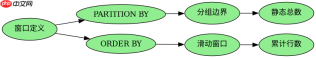
当需要查看分组内的累计行数时,可以在窗口函数中加入 ORDER BY 子句。这会改变窗口的滑动范围,从静态的“全组”变为动态的“当前行及之前”。这种用法常用于计算排名或进度。
SELECT id, name, COUNT(*) OVER (PARTITION BY dept ORDER BY id) AS running_count FROM employees;
空值对窗口计数的影响
窗口函数中的 COUNT(*) 会统计分区内的所有行,包括包含 NULL 值的行。这与普通的聚合 COUNT(column) 不同,后者会忽略 NULL。因此,在统计分组总行数时,COUNT(*) 是最准确的选择,它不会因数据缺失而减少计数。


