






在postgresql中优化带limit的排序,核心做法是利用子查询先筛选出少量候选行,再在外层进行排序和取前n条,从而避免对全表或大结果集进行昂贵的文件排序。具体而言,当where条件能大幅减少数据量但无法利用索引直接满足order by时,这种“子查询过滤+外层排序”的模式通常比直接在大数据集上排序更高效。通过让内层查询利用索引快速定位符合条件的行,外层仅需对极少量的数据进行排序,显著降低了cpu和i/o开销。
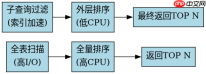
为什么直接排序在大结果集上效率低
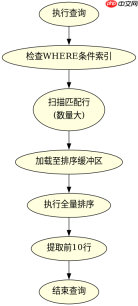
直接对大结果集使用ORDER BY LIMIT会导致数据库引擎必须对所有匹配的行进行完整排序,即使最终只需要前几行。这种全量排序不仅消耗大量CPU时间,还可能产生临时磁盘文件(Temp File),导致I/O瓶颈。例如,如果WHERE条件返回了百万级数据,而LIMIT仅为10,那么99.99%的排序工作都是无效的。
SELECT * FROM large_table
WHERE status = 'active'
ORDER BY created_at DESC
LIMIT 10;
上述查询中,PostgreSQL会扫描所有status为'active'的记录,将它们放入排序缓冲区,全部排完后才取出前10条。如果内存不足,还会发生磁盘交换,性能急剧下降。
如何用子查询结构实现优化
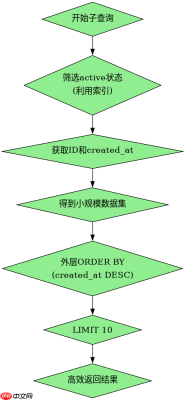
将筛选逻辑放入子查询,确保内层只返回尽可能少的行,外层再对这些行进行排序。这样,内层可以利用索引快速找到符合条件的行ID或主键,外层排序的数据量极小,几乎可以在内存中完成。关键在于内层查询的WHERE条件必须足够选择性,且最好有合适的索引支持。
SELECT * FROM (
    SELECT id, created_at
    FROM large_table
    WHERE status = 'active'
) AS sub
ORDER BY created_at DESC
LIMIT 10;
在这个结构中,内层查询可能利用索引快速定位active状态的记录,只返回id和created_at两列。外层查询仅对这少量行进行排序,效率远高于直接全表排序。注意,内层不应SELECT *,只选必要字段以减少数据传输和内存占用。
基于子查询返回行数与外层排序成本的具体问题
当子查询返回的行数超过一定阈值时,优化效果会减弱甚至消失。因为外层排序的成本随行数线性增长,如果内层筛选不够精确,返回数万行,外层排序依然昂贵。因此,需监控子查询的实际返回行数,确保其保持在千级以下,才能充分发挥优化优势。若内层返回行数过多,应考虑调整WHERE条件或增加复合索引以进一步缩小范围。


