






在postgresql中,使用 limit 和 offset 实现基础分页的核心做法是:先通过 order by 确定排序规则以保证结果稳定,再根据当前页码计算偏移量(offset)并指定每页条数(limit)。具体而言,若每页显示 n 条数据且请求第 p 页,则 sql 语句应包含 offset (p - 1) * n limit n。这种机制会跳过前 (p - 1) * n 行记录,直接返回后续 n 行,适用于数据量适中且对深分页性能不敏感的场景。

如何编写带排序的分页查询语句
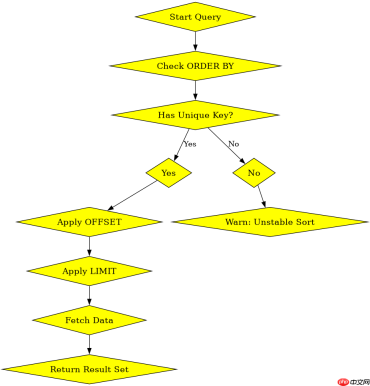
编写带排序的分页查询时,必须确保 ORDER BY 子句包含唯一性字段(如主键),以避免因数据更新导致的页间重复或遗漏。例如,查询用户表第 2 页、每页 10 条数据的标准写法如下:
SELECT id, username, created_at
FROM users
ORDER BY id ASC
LIMIT 10 OFFSET 10;
上述查询中,OFFSET 10 表示跳过前 10 条记录(即第 1 页的 10 条),LIMIT 10 表示从第 11 条开始取 10 条作为第 2 页的结果。由于 id 是唯一主键,排序结果具有确定性,不会出现同一用户在不同页重复出现的情况。执行该语句后,数据库引擎将扫描前 20 行并丢弃前 10 行,仅返回最后 10 行,因此返回的数据类型为包含 10 个用户对象的列表,每个对象包含 id、username 和 created_at 字段。
为什么深分页会导致性能下降
当页码非常大时,OFFSET 的值会变得极大,导致数据库需要扫描并丢弃大量无用数据,从而显著增加 I/O 和 CPU 开销。例如,查询第 10000 页(每页 10 条)时,OFFSET 为 99990,数据库需跳过近十万行记录才能返回目标数据。这种线性增长的开销使得深分页在大数据集上不可接受。为解决此问题,可采用基于游标(Keyset Pagination)的方式,即利用上一页最后一条记录的 ID 作为下一页的起始条件,避免使用 OFFSET。例如,若上一页最后一条记录的 id 为 100000,则下一页查询可写为:SELECT * FROM users WHERE id > 100000 ORDER BY id ASC LIMIT 10。这种方式只需定位到起始位置即可,时间复杂度接近 O(1),不受总数据量影响。对比两种方法,传统分页依赖偏移量,而游标分页依赖索引查找,后者在深分页场景下性能优势明显。

当OFFSET值超过总行数时会返回什么结果
当 OFFSET 的值大于或等于查询结果的总行数时,PostgreSQL 不会报错,而是直接返回空结果集。例如,若用户表中仅有 5 条记录,执行 SELECT * FROM users LIMIT 10 OFFSET 5 将返回 0 行数据。这是因为数据库在跳过 5 行后已无剩余记录可供返回,符合 SQL 标准的行为规范。开发者可通过检查返回结果的数量是否为 0 来判断是否到达最后一页,无需额外处理异常。这一特性简化了前端分页逻辑,无需单独查询总行数即可实现“无更多数据”的判断。


