






排查sql server中left join导致的tempdb溢出,核心在于定位产生大量中间结果集且无法完全放入内存的算子,通常是大哈希连接(hash match)或排序操作。通过检查执行计划中的spill属性、调整索引以支持查找而非扫描、优化join条件以减少参与运算的行数,以及必要时强制使用嵌套循环连接,可以有效解决此问题。
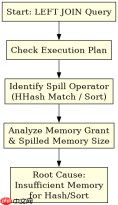
如何识别执行计划中发生溢出的具体算子
识别溢出的关键在于分析执行计划XML或图形界面中的警告标记。当某个算子需要写入TempDB时,其属性中会出现`SpillToTempDb`为True的标志,或者在图形界面中显示黄色感叹号并标注“Spilled TempDB”。这通常发生在哈希连接(Hash Match)构建或探测阶段,或者在大排序(Sort)操作中。通过查询系统动态管理视图,可以获取更详细的内存授予和溢出信息。
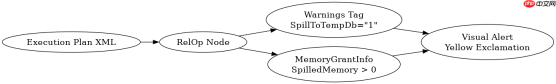
<?xml version="1.0" encoding="utf-8"?><showplanxml xmlns="http://schemas.microsoft.com/sqlserver/2004/07/showplan"><batchsequence><batch><statements><stmtsimple statementtext="SELECT * FROM A LEFT JOIN B ON A.id = B.id"><queryplan cachedplansize="10" compiletime="100" compilecpu="50" compilememory="200"><relop nodeid="0" physicalop="Hash Match" logicalop="Left Outer Join" estimaterows="1000" estimateio="0.1" estimatecpu="0.01" avgrowsize="100" estimatedtotalsubtreecost="0.5" parallel="0" estimaterebinds="0" estimaterewinds="0" estimatedexecutionmode="row"><memorygrantinfo memorygrant="524288" delayedgrant="0" usedmemory="524288" spilledmemory="1048576"></memorygrantinfo><outputlist><columnreference database="[MyDB]" schema="[dbo]" table="[A]" column="id"></columnreference></outputlist><runtimeinformation><runtimecountersperthread thread="0" reaches="1000" expression="EVALS(1000)"></runtimecountersperthread></runtimeinformation><warnings spilltotempdb="1"></warnings><nestedloops></nestedloops><hashmatch><buildresidual></buildresidual><proberesidual></proberesidual><object distribution="Random" reference="[B].[id]"></object>
                <object reference="[A].[id]"></object>
              </hashmatch></relop></queryplan></stmtsimple></statements></batch></batchsequence></showplanxml>
上述XML片段展示了一个典型的Hash Match节点,其中`SpilledMemory`字段明确指出了溢出到TempDB的字节数(此处约为1MB),同时`Warnings`标签中的`SpillToTempDb="1"`是图形界面中警告的来源。开发者应重点关注`RelOp`节点的`PhysicalOp`属性,确认是Hash Match还是Sort导致了溢出,并查看`MemoryGrantInfo`中的实际内存使用情况与授予内存的对比。
如何通过索引和查询重写减少JOIN的数据量
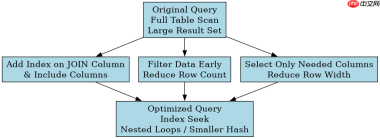
减少TempDB溢出的最有效手段是缩小参与JOIN操作的数据集。对于LEFT JOIN,确保右表(被驱动表)在JOIN列上有合适的索引,可以将Hash Match转换为Nested Loops,后者通常不需要大量的临时内存。如果必须使用Hash Match,可以通过添加WHERE子句过滤左表或右表的无关数据,从而降低哈希桶的大小。此外,避免SELECT *,只选取必要的列,也能减少每行数据的宽度,进而降低内存占用。
-- 原始低效查询,可能导致大表全扫描和内存溢出
SELECT a.*, b.*
FROM LargeTableA a
LEFT JOIN LargeTableB b ON a.id = b.a_id
WHERE a.create_date > '2023-01-01';

-- 优化后:利用索引进行查找,并仅选择必要列
-- 假设 b.a_id 上有索引
SELECT a.id, a.name, b.value
FROM LargeTableA a
INNER JOIN LargeTableB b ON a.id = b.a_id
WHERE a.create_date > '2023-01-01';

-- 如果必须保留LEFT JOIN特性,确保右表索引覆盖JOIN列
-- 创建覆盖索引示例
CREATE INDEX IX_LargeTableB_a_id_value ON LargeTableB(a_id) INCLUDE (value);
在优化后的代码中,通过创建包含JOIN列和返回列的覆盖索引,数据库引擎可以更高效地访问数据。如果业务逻辑允许,将LEFT JOIN改为INNER JOIN可以进一步减少结果集大小,因为INNER JOIN允许优化器更灵活地选择连接顺序和算法。如果LEFT JOIN是必须的,确保右表的JOIN列有非空约束和索引,这样可以避免处理NULL值带来的额外复杂性,并可能触发更优的执行计划。
当LEFT JOIN涉及大文本字段时如何处理
当LEFT JOIN涉及的表中包含VARCHAR(MAX)、NVARCHAR(MAX)或VARBINARY(MAX)等大文本字段时,即使行数不多,也可能因为单行数据过大而导致内存授予不足,进而引发TempDB溢出。SQL Server在处理这些类型时,会将大部分数据存储为LOB(Large Object)页,但在JOIN过程中,如果需要比较或投影这些列,仍可能需要将其加载到工作区。解决这一问题的方法是尽量避免在JOIN条件和SELECT列表中包含大文本字段,或者使用拆分表的方式,将大文本字段分离到另一个表中,仅通过主键关联。
例如,如果表A有一个巨大的Description字段,而JOIN只需要基于ID,那么应将Description字段移至表A_Details,并在查询中仅在需要时单独检索。这样,JOIN操作只在小尺寸的元数据上进行,大大降低了内存压力。此外,检查统计信息是否过时,过时的统计信息可能导致优化器选择错误的执行计划,如错误地估计行数而分配过少的内存,因此定期更新统计信息也是预防溢出的重要措施。





