






在sql查询中根据多层级组织机构进行逐级汇总,核心做法是利用递归cte(common table expression)将层级关系展开为扁平列表,再结合窗口函数或分组聚合计算各级别的数据。具体而言,需要定义一个包含组织id、父级id和基础数据的表结构,通过自连接向上追溯直到根节点,从而确定每个叶子节点所属的所有上级组织。这样做可以直接得到每个组织及其所有子组织的汇总结果,避免了逐层手动查询的繁琐。
如何构建递归CTE以展开层级关系
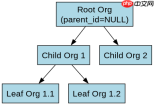
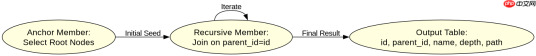
构建递归CTE的关键在于设置正确的锚点成员和递归成员。锚点成员通常选择根节点(即父级ID为空或为特定标识的组织),递归成员则通过当前节点的ID去匹配下一层级的父级ID。这样可以将树状结构“拉直”,每一行代表一个组织及其在树中的深度路径。例如,如果有一个名为 org_tree 的表,包含 id, parent_id, name 字段,我们可以从根节点开始,逐步向下关联子节点,生成一个包含所有层级关系的临时结果集。这一步是后续汇总的基础,确保每个组织都能被正确识别并关联到其所有后代。
WITH RECURSIVE org_hierarchy AS (
    SELECT id, parent_id, name, 0 as depth, CAST(id AS CHAR(255)) as path
    FROM organizations
    WHERE parent_id IS NULL
    UNION ALL
    SELECT o.id, o.parent_id, o.name, oh.depth + 1, CONCAT(oh.path, '-', o.id)
    FROM organizations o
    INNER JOIN org_hierarchy oh ON o.parent_id = oh.id
)
SELECT * FROM org_hierarchy;
上述代码展示了如何从根节点开始递归展开。首先,锚点部分选取 parent_id IS NULL 的记录作为起点,初始化深度为0,路径为自身ID。接着,递归部分将当前层级 oh 与下一级 o 通过 parent_id = id 连接,深度加1,路径追加子节点ID。最终输出的 path 列可用于快速判断层级关系,而 depth 列可用于控制展示层级。运行此查询后,将获得一个包含所有组织及其层级信息的扁平表,为下一步的数值汇总做好准备。
如何在展开后的数据上进行逐级汇总
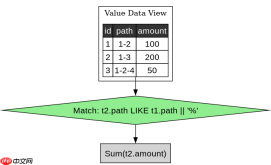
在获得层级展开表后,逐级汇总可以通过两种主要方式实现:一是使用窗口函数的 SUM() OVER (PARTITION BY ...) 结合路径前缀匹配;二是使用自连接将每个组织与其所有后代关联后进行 GROUP BY。第一种方法更简洁,适用于大多数现代数据库系统。具体做法是,利用之前生成的 path 列,对于任意一个组织,其所有子组织的 path 都会以该组织的 path 开头。因此,可以通过 LIKE 操作符或字符串函数来筛选出属于某组织的所有后代,然后对它们的数值字段求和。这种方法不需要额外的复杂逻辑,直接基于路径字符串即可完成聚合。
WITH RECURSIVE org_hierarchy AS (
    SELECT id, parent_id, name, 0 as depth, CAST(id AS CHAR(255)) as path
    FROM organizations
    WHERE parent_id IS NULL
    UNION ALL
    SELECT o.id, o.parent_id, o.name, oh.depth + 1, CONCAT(oh.path, '-', o.id)
    FROM organizations o
    INNER JOIN org_hierarchy oh ON o.parent_id = oh.id
),
value_data AS (
    SELECT oh.id, oh.name, oh.path, oh.depth,
           COALESCE(s.amount, 0) as amount
    FROM org_hierarchy oh
    LEFT JOIN sales s ON oh.id = s.org_id
)
SELECT
    t1.id as org_id,
    t1.name as org_name,
    SUM(t2.amount) as total_amount
FROM value_data t1
INNER JOIN value_data t2 ON t2.path LIKE CONCAT(t1.path, '%')
GROUP BY t1.id, t1.name
ORDER BY t1.depth, t1.id;
这段代码在递归CTE的基础上增加了销售数据表 sales 的左连接,确保没有销售的组织也能显示为0。关键步骤在于最后的自连接 t1 和 t2,其中 t2.path LIKE CONCAT(t1.path, '%') 确保了 t2 中的所有记录都是 t1 组织或其子组织的后代。通过对 t2.amount 进行求和,并按 t1 分组,即可得到每个组织及其所有子组织的累计销售额。结果按深度和ID排序,便于查看层级结构。这种方法的优点是逻辑清晰,易于维护,且能准确反映层级汇总关系。
如何处理循环引用导致的无限递归错误
在实际应用中,如果组织机构数据存在循环引用(例如A的父级是B,B的父级又是A),递归CTE会陷入无限循环并报错。解决这一问题的方法是引入最大递归次数限制,并在递归过程中检测路径是否重复。虽然标准SQL的递归CTE不支持显式的循环检测,但可以通过限制 MAXRECURSION 选项(如在SQL Server中)或在应用层处理来避免。另一种更稳健的方法是在数据入库时进行校验,确保无环。在查询层面,可以监控递归深度,一旦超过预设阈值(如100层),则停止递归并标记异常。此外,使用 OPTION (MAXRECURSION n) 可以在执行时强制终止过深的递归,防止服务器资源耗尽。对于已存在的脏数据,建议先清洗数据,移除或修正循环引用,再进行汇总查询。


