






oracle rac执行 opatchauto 应用补丁时报错中断,通常是因为 opatchauto 在后台调用了 opatch 工具,而 opatch 在执行过程中遇到了无法自动处理的冲突、依赖缺失或环境异常。要解决这个问题,需要查看具体的错误日志(如 $oracle_base/cfgtoollogs/opatchauto/ 下的日志),定位到导致 opatch 失败的详细原因,然后针对性地解决。
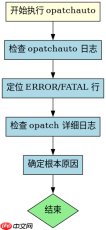
opatchauto 报错时如何快速定位根本原因
当 opatchauto 执行失败时,它会在 $ORACLE_BASE/cfgtoollogs/opatchauto/ 目录下生成详细的日志文件。这些日志记录了每个节点上执行的命令及其输出。要快速定位根本原因,应首先检查 opatchauto-core.log 和 opatchauto-,找到包含 ERROR 或 FATAL 的行。通常,真正的错误信息会隐藏在 opatch 的输出中,因此需要进一步查看 opatch 生成的日志,如 $ORACLE_HOME/.patch_storage/ 下的日志或 /tmp/OraInstall 目录下的日志。通过 grep 搜索 Failed、Conflict 或 Exception 等关键词,可以迅速缩小问题范围。

cd $ORACLE_BASE/cfgtoollogs/opatchauto/\nls -l\ngrep -i "error\|failed" opatchauto-core.log\ngrep -i "error\|failed" opatchauto-*.log
常见导致 opatchauto 中断的具体场景及处理
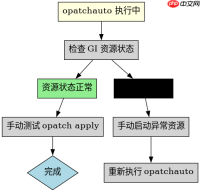
在实际操作中,有几个常见的场景会导致 opatchauto 中断。一是补丁与现有软件存在冲突,例如两个补丁修改了同一个文件但版本不兼容;二是缺少必要的依赖补丁,某些 PSU 或 RU 补丁依赖于特定的 GI 或 DB 补丁;三是文件系统空间不足,导致 opatch 无法解压或写入临时文件;四是权限问题,root 用户无法访问某些 Oracle 文件或目录。针对这些情况,可以通过手动运行 opatch apply 来测试单个节点的补丁应用,从而隔离问题。如果手动应用成功,则可能是 opatchauto 的并行执行逻辑导致的竞争条件;如果手动应用也失败,则根据错误提示修复冲突或安装依赖补丁后,再重新运行 opatchauto。

# 在单个节点上手动测试补丁应用\ncd $ORACLE_HOME\nopatch apply /path/to/patch_id\n# 如果成功,再尝试恢复 opatchauto\nopatchauto apply /path/to/patch_home -oh $ORACLE_HOME -o $ORACLE_HOME
基于 opatchauto 执行中 GI 资源状态的具体问题
在 opatchauto 执行过程中,它会动态管理 GI 资源的状态,例如停止 listener、evmagent 等服务。如果在某个节点上,GI 资源已经处于非预期状态(如 listener 已经被手动停止),opatchauto 可能会因为无法正确获取资源状态而报错中断。此时,需要检查 crsctl stat res -t 的输出,确保所有 GI 资源都处于正常状态。如果发现资源状态异常,可以先使用 crsctl start res 启动资源,然后再重新运行 opatchauto。此外,如果 opatchauto 在某个节点上卡住,可以尝试在该节点上手动执行 opatch auto 命令,以观察是否有更详细的输出信息。
,


