






在oracle 19c中利用flex asm实现存储故障透明切换,核心在于配置asm磁盘组使用redundancy(冗余)策略并依赖flex asm架构的自动故障管理。具体做法是确保数据库实例通过asm集群服务连接,当底层存储路径失效时,asm实例会自动标记磁盘为inactive,并利用镜像副本或奇偶校验数据重建丢失信息,整个过程对上层应用透明,无需手动干预重启实例。

如何配置高冗余磁盘组以支持故障切换
要实现透明切换,必须创建具有外部冗余、正常冗余或高冗余的磁盘组,而非单重冗余。通过SQL*Plus执行CREATE DISKGROUP命令,指定REDUNDANCY参数,例如NORMAL REDUNDANCY需要至少两个故障组(Failure Group),这样当一个故障组对应的物理存储完全不可用时,ASM能立即切换到其他故障组的副本数据,保证I/O不中断。
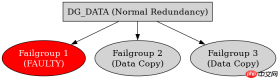
-- 假设已有三个故障组 FG1, FG2, FG3
-- 创建正常冗余磁盘组,每个故障组包含一个磁盘
CREATE DISKDATA DG_DATA NORMAL REDUNDANCY
  FAILGROUP FG1 DISK '/dev/oracle/disk1'
  FAILGROUP FG2 DISK '/dev/oracle/disk2'
  FAILGROUP FG3 DISK '/dev/oracle/disk3';

-- 验证磁盘组状态
SELECT NAME, STATE, TYPE FROM V$ASM_DISKGROUP;
上述代码创建了一个正常冗余的磁盘组DG_DATA。预期结果是磁盘组状态为MOUNTED,且V$ASM_DISK视图中所有磁盘状态为CONNECTED。若模拟FG1所在存储故障,FG1中的磁盘状态将变为DISCONNECTED或OFFLINE,但DG_DATA仍保持MOUNTED状态,数据访问不受影响。
Flex ASM架构如何简化故障恢复流程
Flex ASM允许数据库实例运行在非ASM节点上,通过远程连接ASM实例。这种解耦架构意味着即使某个节点的本地存储出现故障,只要集群网格基础设施可用,数据库实例可以迁移到其他健康节点,或者由远程ASM实例提供服务。配置时需确保OCR和Voting Disk存储在独立的冗余位置,并使用GRID用户管理ASM实例。

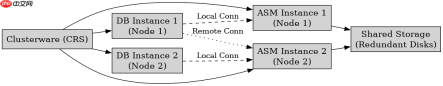
-- 检查ASM实例状态和连接性
SELECT INSTANCE_NAME, STATUS FROM V$INSTANCE;
SELECT NAME, PATH, FAILGROUP, STATE FROM V$ASM_DISK;

-- 查看集群资源状态
crsctl stat res -t
此段代码用于监控当前环境。预期结果是V$ASM_DISK显示所有在线磁盘及其所属故障组。crsctl显示ASM实例和数据库实例均处于ONLINE状态。在Flex ASM模式下,如果本地节点宕机,集群管理器CRS会将数据库实例启动到另一节点,该节点上的ASM实例继续提供存储服务,实现业务连续性。
存储故障发生时ASM的具体行为表现
当发生存储故障时,ASM会检测到磁盘超时(Disk Timeout),通常默认为1.8秒。一旦确认磁盘不可达,ASM会将该磁盘标记为OFFLINE,并触发Rebalance操作(如果配置了自动平衡)。对于冗余磁盘组,ASM会从其他副本读取数据,写入操作也会转向健康的副本。这个过程是自动的,数据库会话可能会经历短暂的I/O延迟,但不会报错ORA-15077等致命错误,除非所有副本都失效。


