






oracle asm磁盘组在单盘掉线时rac没有维持冗余,通常是因为该磁盘组的冗余级别配置为外部冗余(external redundancy)或普通冗余(normal redundancy)但故障域(failure group)划分不当导致所有副本位于同一物理节点。要解决这个问题,需要检查`v$asm_diskgroup`视图中的`type`列确认冗余类型,并通过`alter diskgroup ... add failure group`命令重新规划数据分布。
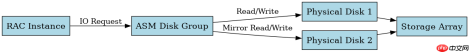
如何确认当前磁盘组的冗余类型
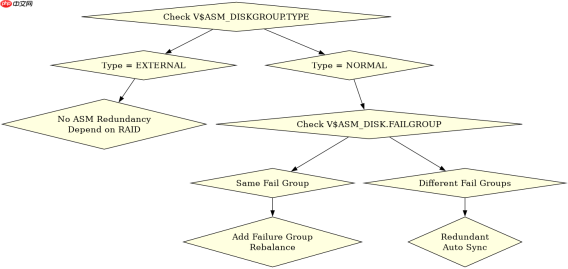
首先通过查询`V$ASM_DISKGROUP`视图的`TYPE`字段来确认磁盘组的冗余策略。如果`TYPE`显示为`EXTERNAL`,则ASM不管理任何镜像副本,完全依赖底层存储阵列的RAID保护,此时单盘掉线不会触发ASM层面的数据重建,RAC实例可能因IO错误而挂起。如果`TYPE`为`NORMAL`,则ASM维护主镜像和副镜像,单盘掉线应触发自动同步,但若未看到冗余恢复,需进一步检查故障域配置。
SELECT NAME, TYPE, TOTAL_MB, FREE_MB FROM V$ASM_DISKGROUP;
执行上述SQL后,观察返回结果。若`TYPE`列为`EXTERNAL`,说明当前配置无ASM级冗余。若为`NORMAL`,继续检查`V$ASM_DISK`视图中的`FAILGROUP`列,确认磁盘是否均匀分布在不同的故障域中。若所有磁盘属于同一故障域,单节点故障会导致整个磁盘组不可用,而非仅单盘降级。
如何修复故障域配置以支持单盘容错
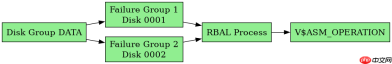
当发现故障域配置不合理时,需通过添加新的故障域并迁移数据来修复。使用`ALTER DISKGROUP`命令将磁盘分配到不同的故障域,确保每个故障域对应独立的物理控制器或节点路径。例如,将磁盘`DATA_0001`和`DATA_0002`分别加入`FG1`和`FG2`,使ASM能在不同物理位置存储副本。

ALTER DISKGROUP DATA ADD FAILURE GROUP FG1 DISK 'ORCL:DATA_0001';
ALTER DISKGROUP DATA ADD FAILURE GROUP FG2 DISK 'ORCL:DATA_0002';
ALTER DISKGROUP DATA REBALANCE;
执行上述命令后,ASM会启动后台进程`RBAL`进行数据重平衡。监控`V$ASM_OPERATION`视图可跟踪重平衡进度。重平衡完成后,再次查询`V$ASM_DISKGROUP`确认状态正常。此时,单盘掉线将仅导致一个故障域降级,RAC实例可通过另一故障域的副本继续访问数据,维持高可用性。
单盘掉线后RAC实例为何仍报错
即使配置了普通冗余,单盘掉线后RAC实例仍可能报错,原因通常是应用层未正确处理ASM的IO超时或缓存失效。ASM在单盘故障时会标记磁盘为`DROPPED`,并尝试从其他副本读取数据。若应用层连接字符串未配置`FAILOVER`参数,或数据库实例未启用`INSTANCE_GROUPS`,可能导致连接中断。此外,若故障域内所有磁盘同时损坏,ASM无法提供冗余,实例将直接报错。


