






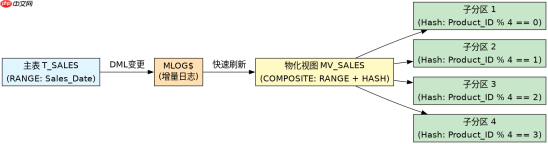
在oracle 19c中,利用复合分区(composite partitioning)优化物化视图刷新的核心做法是将物化视图按时间范围(range)和哈希(hash)进行二级分区。具体而言,外层使用range分区按业务日期划分数据块,内层使用hash分区将每个时间块内的数据均匀分布到多个子分区中。这样做的好处是,在执行快速刷新(fast refresh)时,oracle可以仅扫描并处理发生变化的特定子分区,从而显著减少日志读取量和i/o开销。
如何定义支持快速刷新的复合分区结构
要实现上述优化,必须在创建物化视图时显式指定COMPOSITE PARTITION BY子句。关键在于确保主表也具备相同的分区键或兼容的分区结构,以便Oracle能够准确追踪增量变化。通常,我们将主表的日期字段作为外层分区的依据,而将主键或业务ID的哈希值作为内层分区的依据。这种结构不仅加速了查询时的分区裁剪,也为物化视图的快速刷新提供了细粒度的数据定位能力。
-- 假设主表 t_sales 已按 sales_date 范围分区
CREATE MATERIALIZED VIEW mv_sales_composite
BUILD IMMEDIATE
REFRESH FAST ON COMMIT
ENABLE QUERY REWRITE
PARTITION BY RANGE (sales_date)
SUBPARTITION BY HASH (product_id)
SUBPARTITIONS 4
(
  PARTITION p_2023_q1 VALUES LESS THAN (TO_DATE('2023-04-01', 'YYYY-MM-DD')),
  PARTITION p_2023_q2 VALUES LESS THAN (TO_DATE('2023-07-01', 'YYYY-MM-DD')),
  PARTITION p_2023_q3 VALUES LESS THAN (TO_DATE('2023-10-01', 'YYYY-MM-DD')),
  PARTITION p_max VALUES LESS THAN (MAXVALUE)
)
AS SELECT * FROM t_sales;
上述代码创建了一个名为 mv_sales_composite 的物化视图。它首先根据 sales_date 进行范围分区,然后对每个分区内的 product_id 进行哈希子分区,共4个子分区。执行此语句后,物化视图的数据将物理上分散在这些子分区中。当主表 t_sales 发生DML操作时,MLOG$(物化视图日志)会记录变更,而物化视图刷新过程只会针对受影响的分区子集进行应用,避免了全表扫描。
复合分区如何影响刷新策略的选择与性能
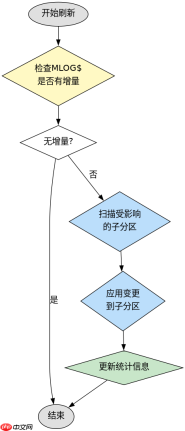
在确定了复合分区结构后,选择合适的刷新策略至关重要。对于高并发写入场景,推荐使用 ON COMMIT 模式,因为复合分区允许Oracle在事务提交时,仅锁定并更新涉及变更行的特定子分区,从而降低锁竞争。若业务允许轻微延迟,可采用 ON DEMAND 结合 FAST 刷新,并在非高峰时段执行,此时系统会利用分区元数据快速定位增量数据。需要注意的是,如果主表未建立相应的分区索引或物化视图日志未包含必要的列(如ROWID或伪列),快速刷新可能会退化为完全刷新,导致性能骤降。

-- 检查物化视图日志是否支持快速刷新
SELECT * FROM USER_MVIEW_LOGS WHERE MVIEW_NAME = 'MV_SALES_COMPOSITE';

-- 手动触发快速刷新,观察执行计划中的分区访问情况
EXEC DBMS_MVIEW.REFRESH('MV_SALES_COMPOSITE', 'F');
通过运行上述PL/SQL块,可以手动触发快速刷新。在实际执行中,可以通过查看AWR报告或执行计划,确认数据库是否利用了分区修剪(Partition Pruning)。如果看到访问路径中包含具体的分区编号(如 PARTITION: RANGE 1),则说明复合分区优化生效。反之,若出现全分区扫描,则需检查物化视图日志的定义是否完整,特别是是否包含了所有用于关联的键值列。
当主表发生大规模批量插入时物化视图如何处理
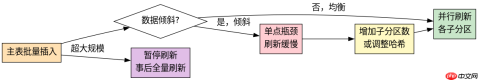
在主表经历大规模批量插入(Bulk Insert)时,复合分区的优势体现在并行处理能力上。由于数据被哈希分散到多个子分区,Oracle可以利用并行执行特性,同时向不同的子分区加载数据或应用刷新日志。然而,如果批量插入导致某些子分区数据倾斜(即某个子分区数据量远大于其他),可能会成为刷新瓶颈。此时,建议调整哈希算法或增加子分区数量以平衡负载。此外,对于超大规模数据,可考虑在批量操作期间暂停物化视图刷新,待数据加载完成后统一执行一次完全刷新或合并刷新,以避免频繁的日志累积和碎片化。


