






使用正则表达式 preg_match_all 配合模式 /[\x{4e00}-\x{9fa5}]+(\d+(?:\.\d+)?)/u 可以从中文文本中提取数字。该做法会匹配所有包含中文字符和数字的片段,并提取其中的数值部分。如果输入字符串中没有混合中英文与数字的内容,则不会返回任何结果。
如何从混合文本中准确提取连续数字
通过 preg_match_all 函数可以一次性获取所有匹配项。需要设置 PREG_SET_ORDER 标志以便按顺序处理结果。此方法能区分纯数字串和混合串中的数字部分。
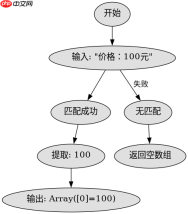
<?php $text = "价格:100元,折扣:20.5%";
preg_match_all('/[\x{4e00}-\x{9fa5}]+(\d+(?:\.\d+)?)/u', $text, $matches);
print_r($matches[1]);
?>
预期输出为:
Array
(
[0] => 100
[1] => 20.5
)
如何处理非标准格式的数字提取
当文本中包含逗号分隔或科学计数法时,上述正则可能失效。此时应改用更宽松的模式 /[\x{4e00}-\x{9fa5}]*([\d,]+(?:\.[\d]+)?)/u 以支持千分位逗号。若需排除纯数字行,可结合 mb_strlen 判断长度。

<?php $text = "总数:1,234.56,总计:890";
preg_match_all('/[\x{4e00}-\x{9fa5}]*([\d,]+(?:\.[\d]+)?)/u', $text, $matches);
foreach ($matches[1] as $num) {
    echo str_replace(",", "", $num) . "\n";
}
?>
预期输出为:
1234.56
890
基于输入中无中文时的具体行为
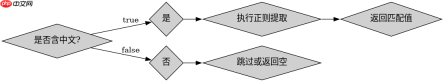
当输入字符串仅包含数字而无任何中文字符时,正则表达式 /[\x{4e00}-\x{9fa5}]+(\d+(?:\.\d+)?)/u 将不会匹配任何内容。这是因为该模式要求至少一个中文字符作为前缀条件。因此,preg_match_all 返回空数组。若需兼容纯数字场景,应调整正则使其可选中文字段,例如改为 /[\x{4e00}-\x{9fa5}]*(\d+(?:\.\d+)?)/u。但当前实现严格依赖中文存在,故在无中文输入时结果为空。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





