






ip_hash 导致 502 Bad Gateway 的排查思路
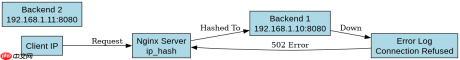
当 nginx 配置了 ip_hash 但出现 502 bad gateway 时,通常是因为客户端 ip 被固定哈希到某个后端服务器,而该服务器宕机或连接失败。排查的核心是确认 nginx 是否真的将请求发往了错误的后端,以及后端服务的健康状态。通过检查 nginx 错误日志中的 upstream 报错信息,可以定位具体是哪个后端节点不可用。
如何验证 ip_hash 的会话保持行为
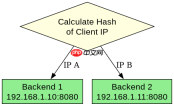
要验证 ip_hash 是否生效以及它如何将流量导向特定后端,可以使用 curl 命令模拟不同来源的请求。由于 ip_hash 基于客户端 IP 进行哈希计算,同一 IP 的所有请求会被发送到同一个后端。我们可以通过查看后端服务返回的标识来确认路由结果。
upstream backend {
    ip_hash;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
}
上述配置中,Nginx 会根据客户端 IP 计算哈希值,并将所有来自同一 IP 的请求转发到 192.168.1.10 或 192.168.1.11。如果 192.168.1.10 挂了,而 ip_hash 仍然尝试连接它,就会触发 502。为了验证这一点,我们可以启动一个简单的后端服务,并观察 Nginx 的错误日志。

后端服务宕机时的具体表现与处理
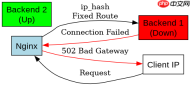
当使用 ip_hash 时,如果某个后端服务器宕机,Nginx 默认不会自动将该 IP 的流量切换到其他正常节点,除非配置了 max_fails 和 fail_timeout。这会导致持续 502 错误。我们需要检查 Nginx 错误日志,确认是否有 connect() failed (111: Connection refused) 或类似的错误信息。
# Nginx 错误日志示例
2023-10-01 10:00:00 [error] 1234#0: *1 connect() failed (111: Connection refused) while connecting to upstream, client: 192.168.1.100, server: example.com, request: "GET / HTTP/1.1", upstream: "http://192.168.1.10:8080", host: "example.com"
从日志可以看出,Nginx 尝试连接 192.168.1.10:8080 时被拒绝。这是因为 ip_hash 将该客户端 IP 固定到了这个节点。为了解决这个问题,需要确保后端服务器的健康检查机制正常工作,或者调整 ip_hash 的配置,例如增加 max_fails 参数,以便在服务器失败后能够暂时跳过该节点。








