谷歌 deepmind 近期发布了名为“解耦式 diloco”的全新分布式训练框架,该技术致力于提升超大规模人工智能模型的训练效能,同时显著增强系统在硬件异常情况下的容错能力。
在传统训练范式中,所有计算节点必须严格同步执行梯度更新操作,这种强耦合机制极易因单个设备宕机而导致整体训练流程中断。为突破这一瓶颈,解耦式 DiLoCo 引入了“计算孤岛”设计理念——将训练任务划分为多个彼此隔离、异步运行的独立计算域,各单元可自主推进本地训练,无需与其他节点保持实时协调。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
该架构的关键创新在于以“学习单元”为基本调度单位,每个单元在本地完成多轮前向与反向传播后,仅上传经高度压缩的梯度摘要至中央优化器进行聚合更新。得益于异步通信机制,任一学习单元发生故障均不会阻塞其余单元的持续训练,从而彻底规避了传统同步训练中常见的单点失效风险。

在 Linux 上通过 Chrome 挂载/VNC 自动发布小红书长笔记。Agent 撰写标题和正文后执行 xhs_publish.sh --publish --submit,触发小红书发布。
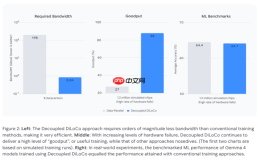
实测数据显示,在模拟高频率硬件故障的场景下,解耦式 DiLoCo 仍可保持高达 88% 的有效计算资源利用率,相比之下,常规数据并行方案仅维持在 27% 左右。更进一步,该架构将跨地域数据中心间所需的通信带宽由原先的 198 Gbps 剧降至 0.84 Gbps,使得依托现有商用互联网链路开展全球范围内的协同训练成为现实。
尤为突出的是,解耦式 DiLoCo 内置自恢复机制。在混沌工程压力测试中,即便某个完整的学习单元完全离线,系统仍能维持训练连续性;待该单元恢复正常后,可自动完成状态同步与无缝接入。该特性具备良好的硬件兼容性,支持不同代际的 TPU 芯片在同一训练任务中混合部署,不仅提升了老旧设备的复用价值,也有效缓解了硬件迭代周期中可能出现的算力供给缺口。