






java 8 的并行流(parallel stream)无法直接对 `hashmap` 进行原地修改,因为 `hashmap` 不是线程安全的。处理大数据的正确做法是将数据转换为流后,使用 `collectors.toconcurrentmap()` 收集结果,或者在 java 9+ 中使用 `collectors.groupingbyconcurrent()`。对于需要聚合的场景,推荐使用 `computeifabsent` 配合原子操作或并发集合,以避免竞态条件。

如何安全地将 List 转为 Map
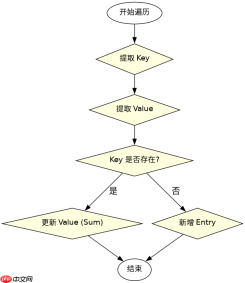
将 List 中的对象提取为 Map 时,应使用 `toConcurrentMap` 收集器。它内部使用了分段锁(Segmented Locking)机制,允许多个线程同时写入不同的桶,从而提升性能。关键参数是合并函数(merge function),用于处理键冲突。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        List<string> data = Arrays.asList("a", "b", "c", "a");

        // 使用 toConcurrentMap 并行转换
        Map<string long> map = data.parallelStream()
            .collect(Collectors.toConcurrentMap(
                s -> s,           // keyMapper
                s -> 1L,          // valueMapper
                Long::sum         // mergeFunction
            ));

        System.out.println(map);
    }
}</string></string>
预期输出:{a=2, b=1, c=1}。注意,如果键不唯一,必须提供 mergeFunction,否则抛出 IllegalStateException。
如何处理复杂对象的分组统计
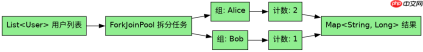
当需要对对象列表按字段分组并统计时,`groupingByConcurrent` 是比 `groupingBy` 更优的选择。它同样基于 ForkJoinPool 工作窃取模型,适合 CPU 密集型任务。需指定下游收集器,如 `counting()`。

import java.util.*;
import java.util.stream.*;

class User {
    String name;
    int age;
    User(String n, int a) { name=n; age=a; }
}

public class GroupingMain {
    public static void main(String[] args) {
        List<user> users = Arrays.asList(
            new User("Alice", 25),
            new User("Bob", 30),
            new User("Alice", 26)
        );

        // 并行分组统计
        Map<string long> countMap = users.parallelStream()
            .collect(Collectors.groupingByConcurrent(
                u -> u.name,
                Collectors.counting()
            ));

        System.out.println(countMap);
    }
}</string></user>
预期输出:{Alice=2, Bob=1}。此方法避免了手动同步开销,由框架自动管理线程间的数据合并。
为什么 HashMap 不能直接用于并行流收集
`HashMap` 的内部结构包含数组和链表/红黑树,其 `put` 操作会修改内部状态。在多线程环境下,多个线程同时调用 `put` 可能导致链表断裂、死循环或数据覆盖。因此,标准库提供了 `ConcurrentHashMap` 作为替代,但并行流收集器仍推荐使用专门的收集器而非直接传入 `ConcurrentHashMap::new` 作为映射工厂,除非你明确知道如何正确处理合并逻辑。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


