






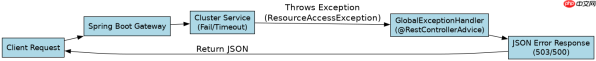
spring boot 全局异常处理通过 @restcontrolleradvice 和 @exceptionhandler 捕获集群故障异常,核心做法是拦截 remoteexception、connecttimeoutexception 或自定义的 clusterexception。在 advice 类中定义对应方法的返回值,返回统一的 json 错误结构(如包含错误码和提示信息的对象),从而将底层的网络或服务不可用异常转化为前端可感知的业务响应。若未配置此类处理器,集群故障会直接导致 http 500 状态码及堆栈信息泄露。
如何配置全局异常处理器拦截远程调用异常
配置全局异常处理器需要创建一个继承自 ControllerAdvice 的类,并使用 @RestControllerAdvice 注解使其自动生效。在该类中,使用 @ExceptionHandler 指定要捕获的具体异常类型,例如 java.net.ConnectException 或 org.springframework.web.client.ResourceAccessException。当集群中的某个节点宕机或网络超时导致 Feign 或 RestTemplate 调用失败时,Spring MVC 会自动将这些异常路由到该处理方法中,开发者可以在这里构建标准的错误响应体。
import org.springframework.web.bind.annotation.ExceptionHandler;
import org.springframework.web.bind.annotation.RestControllerAdvice;
import org.springframework.web.client.ResourceAccessException;

@RestControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(ResourceAccessException.class)
    public ErrorResponse handleClusterFailure(ResourceAccessException e) {
        // 记录日志以便排查集群节点状态
        System.err.println("Cluster node unreachable: " + e.getMessage());
        return new ErrorResponse(503, "Service Unavailable", "Backend cluster is currently unavailable");
    }
}
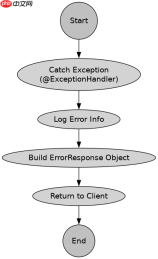
上述代码展示了最基础的拦截逻辑。当 ResourceAccessException 被抛出时,程序不会进入默认的 Spring Boot 错误页面,而是执行 handleClusterFailure 方法。该方法返回一个 ErrorResponse 对象,Spring 会自动将其序列化为 JSON 字符串返回给客户端。这种机制确保了即使底层基础设施出现故障,API 接口依然保持稳定的契约格式。

如何处理集群故障时的降级与重试策略配合
在处理集群故障异常时,单纯返回错误信息往往不够,通常需要结合熔断器或重试机制。虽然
ClusterDownException
,可以在服务层明确区分“临时网络抖动”和“集群完全不可用”。在全局异常处理器中,针对该特定异常返回明确的 SERVICE_UNAVAILABLE 状态码。这种做法使得前端可以根据不同的错误码采取不同的 UI 策略,例如显示“系统维护中”而非简单的“服务器错误”,提升了用户体验的可控性。
集群故障异常中如何安全地提取根因异常信息
集群故障引发的异常往往是嵌套的,例如 ResourceAccessException 内部可能包裹着 SocketTimeoutException 或 NoHttpResponseException。为了提供精确的错误诊断信息,全局异常处理器需要深入提取这些根因异常。直接使用 e.getCause() 或遍历异常链来获取最底层的错误原因,可以避免向客户端暴露过于宽泛的“连接失败”信息,而是明确指出是“超时”、“拒绝连接”还是“主机未知”。这有助于运维人员快速定位是 DNS 问题、防火墙拦截还是目标服务进程崩溃。


