






在 linux 高并发场景下,优化 nginx 代理超时参数的核心做法是缩短客户端等待时间并防止后端资源被无效占用。具体而言,应将 proxy_connect_timeout、proxy_send_timeout 和 proxy_read_timeout 设置为合理的短值(如 5-10 秒),同时配合 keepalive_timeout 和 worker_connections 调整连接生命周期。这样可以在后端服务响应缓慢或挂起时,快速释放 nginx 工作进程的资源,避免大量连接堆积导致服务器崩溃。
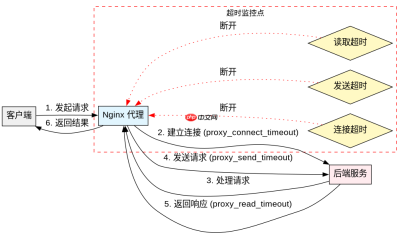
如何设置代理超时的关键参数
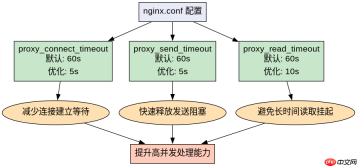
直接回答:通过修改 nginx.conf 中的 http 块配置,调整三个核心超时参数即可生效。主要涉及 proxy_connect_timeout(建立连接超时)、proxy_send_timeout(发送请求超时)和 proxy_read_timeout(读取响应超时)。将这些值从默认的 60 秒降低到 5-10 秒,可以显著减少高负载下的资源占用。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_servers;

        # 优化后的超时参数
        proxy_connect_timeout 5s;   # 与后端建立连接的超时时间
        proxy_send_timeout 5s;      # 向后端发送请求的超时时间
        proxy_read_timeout 10s;     # 等待后端响应的超时时间

        # 保持长连接配置
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
上述配置中,proxy_connect_timeout 控制 Nginx 与后端服务器建立 TCP 连接的时间。如果后端服务启动慢或网络拥堵,这个值过短会导致大量连接失败。因此,通常建议将其设为与 proxy_send_timeout 相近的值。proxy_read_timeout 是最关键的参数,它定义了两次成功读取操作之间的间隔。在高并发下,如果后端处理逻辑复杂导致响应变慢,Nginx 会在此超时后断开连接,返回 504 Gateway Time-out 错误给客户端,从而释放工作进程去处理其他请求。
如何配合 Keepalive 连接优化性能
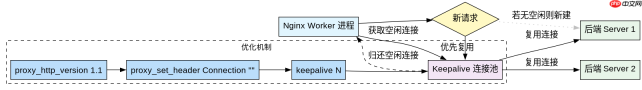
直接回答:在高并发代理场景中,单纯调整超时参数不够,必须启用 HTTP Keepalive 连接池以减少 TCP 握手开销。通过在 upstream 块中配置 keepalive 指令,并在 location 中清除 Connection 头部,Nginx 可以复用与后端的空闲连接,提高吞吐量并降低延迟。

upstream backend_servers {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;

    # 每个 worker 进程保持的空闲连接数
    keepalive 32;
}

server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_servers;

        # 关键:使用 HTTP/1.1 以支持 Keepalive
        proxy_http_version 1.1;
        # 关键:清除 Connection 头,允许 Nginx 管理连接复用
        proxy_set_header Connection "";

        proxy_connect_timeout 5s;
        proxy_read_timeout 10s;
    }
}
在这个配置中,keepalive 32 表示每个 Nginx worker 进程最多保持 32 个与上游服务器的空闲连接。当新请求到来时,Nginx 优先从池中获取空闲连接,而不是新建 TCP 连接。配合 proxy_http_version 1.1 和 proxy_set_header Connection "",确保了连接不会在每次请求后被后端关闭。这种组合在高并发下能大幅减少 CPU 和内存消耗,因为避免了频繁的三次握手和四次挥手。需要注意的是,如果后端服务不支持 Keepalive,或者配置不当,可能导致连接泄漏,因此需监控后端日志确认连接状态。
当后端响应极慢时如何避免雪崩
直接回答:当后端服务响应极慢或无响应时,仅靠超时参数可能不足以阻止雪崩效应,需要结合 proxy_next_upstream 和 max_fails 机制进行故障转移。通过将请求自动转发到其他健康节点,并限制失败次数,可以快速隔离异常后端,保护整体服务的可用性。
upstream backend_servers {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=10s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=10s;

    keepalive 32;
}

server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_servers;

        # 定义哪些错误触发重试
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;

        # 重试次数限制
        proxy_next_upstream_tries 2;

        proxy_http_version 1.1;
        proxy_set_header Connection "";

        proxy_connect_timeout 5s;
        proxy_read_timeout 10s;
    }
}
在上述配置中,max_fails=3 和 fail_timeout=10s 定义了后端服务器的健康检查策略。如果某个后端在 10 秒内失败 3 次,Nginx 会在接下来的 10 秒内将该服务器标记为不可用,不再向其发送请求。proxy_next_upstream 指令指定了当发生超时、错误或非 2xx/3xx 状态码时,Nginx 应尝试将请求转发给下一个可用的后端服务器。这种机制在高并发且后端不稳定的场景下至关重要,它能确保即使部分节点响应缓慢,整体服务仍能通过故障转移维持正常运行,避免所有请求堆积在同一个慢速节点上导致系统雪崩。








