






解读oracle awr报告中的load profile,核心在于通过单位时间内的操作频率和负载占比,定位系统的性能瓶颈。你需要重点关注“per second”列的绝对数值变化以及“per transaction”列的效率指标,结合cpu、i/o和等待事件来综合判断。例如,若“redo size per second”激增,通常意味着大量数据修改或日志切换频繁;而“parse count (hard)”过高则指向sql解析开销大。理解这些指标能帮你快速锁定是cpu密集型、io密集型还是应用逻辑问题。
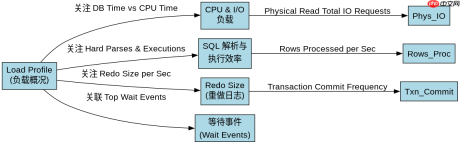
如何区分CPU与I/O负载的关键指标
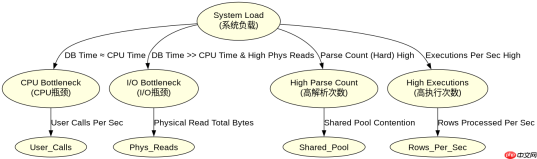
在Load Profile中,区分CPU和I/O负载主要看“DB time”、“CPU time”与物理/逻辑读的关系。如果“DB time per second”接近“CPU time per second”,说明系统主要是CPU瓶颈;如果两者差距大且“Physical read total IO requests”高,则是I/O瓶颈。此外,“User calls per second”反映前端交互压力,而“Executions per second”反映后端处理量。通过对比这些比率,可以明确资源消耗的主要去向。
SELECT
    snap_id,
    begin_interval_time,
    end_interval_time,
    (SELECT value FROM dba_hist_sys_stat WHERE stat_name = 'DB time' AND snap_id = s.snap_id) /
        GREATEST(EXTRACT(EPOCH FROM (end_interval_time - begin_interval_time)), 1) AS db_time_per_sec,
    (SELECT value FROM dba_hist_sys_stat WHERE stat_name = 'CPU time' AND snap_id = s.snap_id) /
        GREATEST(EXTRACT(EPOCH FROM (end_interval_time - begin_interval_time)), 1) AS cpu_time_per_sec,
    (SELECT value FROM dba_hist_sys_stat WHERE stat_name = 'physical read total IO requests' AND snap_id = s.snap_id) /
        GREATEST(EXTRACT(EPOCH FROM (end_interval_time - begin_interval_time)), 1) AS phys_io_per_sec
FROM dba_hist_snapshot s
WHERE snap_id IN (SELECT MAX(snap_id) FROM dba_hist_snapshot);
如何识别SQL解析与执行效率问题
识别SQL解析与执行效率问题,需重点观察“Parse count (total/hard)”、“Executions”和“Rows processed”。Hard parse次数高(Parse count (hard))表明共享池不足或SQL未绑定变量,导致重复解析开销。Executions per second高但Rows processed低,可能意味着查询返回行数少但调用频繁,存在过度查询风险。若“Rows processed per second”极高,则可能是批量操作或全表扫描导致的数据吞吐压力。结合Top SQL分析,可进一步确认具体语句。

-- 假设我们有一个具体的AWR快照ID范围,例如从100到105
-- 以下查询用于获取该时间段内的关键Load Profile指标
SELECT
    ss.snap_id,
    ss.begin_interval_time,
    ss.end_interval_time,
    -- 计算每秒的DB Time
    (ss.db_time_value - LAG(ss.db_time_value) OVER (ORDER BY ss.snap_id)) /
        GREATEST(EXTRACT(EPOCH FROM (ss.end_interval_time - ss.begin_interval_time)), 1) AS db_time_per_sec,
    -- 计算每秒的CPU Time
    (ss.cpu_time_value - LAG(ss.cpu_time_value) OVER (ORDER BY ss.snap_id)) /
        GREATEST(EXTRACT(EPOCH FROM (ss.end_interval_time - ss.begin_interval_time)), 1) AS cpu_time_per_sec,
    -- 计算每秒的物理IO请求数
    (ss.phys_io_value - LAG(ss.phys_io_value) OVER (ORDER BY ss.snap_id)) /
        GREATEST(EXTRACT(EPOCH FROM (ss.end_interval_time - ss.begin_interval_time)), 1) AS phys_io_per_sec,
    -- 计算每秒的Hard Parse次数
    (ss.hard_parse_value - LAG(ss.hard_parse_value) OVER (ORDER BY ss.snap_id)) /
        GREATEST(EXTRACT(EPOCH FROM (ss.end_interval_time - ss.begin_interval_time)), 1) AS hard_parses_per_sec
FROM (
    SELECT
        s.snap_id,
        s.begin_interval_time,
        s.end_interval_time,
        (SELECT value FROM dba_hist_sys_stat st WHERE st.snap_id = s.snap_id AND st.stat_name = 'DB time') AS db_time_value,
        (SELECT value FROM dba_hist_sys_stat st WHERE st.snap_id = s.snap_id AND st.stat_name = 'CPU time') AS cpu_time_value,
        (SELECT value FROM dba_hist_sys_stat st WHERE st.snap_id = s.snap_id AND st.stat_name = 'physical read total IO requests') AS phys_io_value,
        (SELECT value FROM dba_hist_sys_stat st WHERE st.snap_id = s.snap_id AND st.stat_name = 'parse count (hard)') AS hard_parse_value
    FROM dba_hist_snapshot s
    WHERE s.snap_id BETWEEN 100 AND 105
) ss;
基于程序中某个输入、条件或结果的具体问题
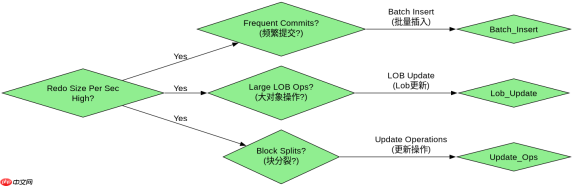
当Load Profile显示“Redo size per second”异常升高时,具体原因往往是事务提交频繁或大对象(LOB)操作。例如,在一个批量插入程序中,如果每行都单独提交,会导致Redo生成量剧增。解决方法是将提交频率降低,如每1000行提交一次,从而显著减少Redo大小。同时,检查是否有大量的UPDATE操作导致块分裂,这也是Redo增长的一个常见原因。通过调整程序的事务边界,可以有效优化这一指标。


