






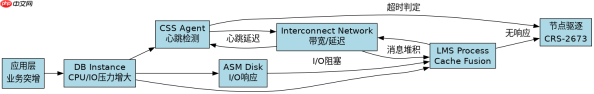
oracle 19c rac在业务突增时出现节点互相驱逐,核心原因是集群资源争用导致的心跳延迟或缓存融合(cache fusion)通信超时,触发了gcs/ges锁服务的异常检测机制。要解决这个问题,必须检查并优化网络带宽、调整cluster synchronization services (css)的超时参数,以及排查是否存在单点故障导致的i/o阻塞。通过监控`gv$session_wait`中的`gc cr request`等待事件和`crsctl stat res -t`的状态变化,可以定位是网络丢包还是磁盘响应慢引发的驱逐。
如何配置CSS心跳参数以应对瞬时负载波动
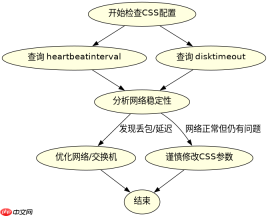
CSS服务负责管理集群成员资格,其默认的心跳间隔和超时时间可能无法适应高并发下的瞬时延迟。当业务突增导致CPU或内存压力增大时,节点处理心跳包的延迟可能超过CSS设定的阈值,从而被误判为失效。可以通过调整`cluster_interconnects`对应的网络接口优先级,或者在极端情况下微调`cssd`的日志级别来观察具体超时原因,但通常不建议直接修改默认的`heartbeat`计数,而是应确保底层网络稳定。
-- 查看当前CSS配置
[grid@node1 ~]$ crsctl get css disktimeout
300
[grid@node1 ~]$ crsctl get css heartbeatinterval
40

-- 注意:生产环境严禁随意修改以下参数,除非有Oracle Support明确指导
-- 修改CSS心跳间隔(示例,需谨慎)
[grid@node1 ~]$ crsctl set css heartbeatinterval 50

-- 检查CSS状态
[grid@node1 ~]$ crsctl check cssd
Cluster Synchronization Services appears healthy
上述命令展示了如何查询当前的CSS心跳间隔和磁盘超时时间。默认情况下,心跳间隔为40毫秒,磁盘超时为300秒。如果业务突增导致网络抖动,心跳丢失累积超过设定值,就会触发驱逐。在实际操作中,应优先排查网络质量,而非盲目增加超时时间,因为过长的超时会导致脑裂风险增加。
如何通过AWR报告定位Cache Fusion争用
业务突增往往伴随着大量的数据块请求,如果两个节点之间的Interconnect网络带宽不足或延迟高,会导致`gc cr request`等待事件激增。这种争用会占用大量CPU周期,进而影响心跳检测和锁管理进程,最终引发节点驱逐。通过分析AWR报告中的Top 5 Timed Events,可以确认是否存在严重的Cache Fusion瓶颈。


-- 查询 gv$session_wait 中相关的等待事件
SELECT event, COUNT(*) wait_count, SUM(p1) total_p1
FROM gv$session_wait
WHERE event LIKE 'gc %' OR event LIKE 'enq %'
GROUP BY event
ORDER BY wait_count DESC;

-- 查询 gv$sysstat 中的GC相关统计
SELECT name, value
FROM gv$sysstat
WHERE name LIKE 'gc %' AND instance_id = 1;
执行上述SQL可以获取实时的GC等待统计。如果`gc cr request`的等待时间显著高于其他事件,说明网络或锁服务存在瓶颈。此时应检查`gv$cluster_interconnects`确认网卡状态,并对比业务高峰期的吞吐量与网络带宽上限。若发现大量重传或校验和错误,则需联系网络团队优化交换机配置或更换更高带宽的网卡。
为什么I/O延迟会间接导致RAC节点驱逐
虽然I/O延迟不直接参与心跳检测,但严重的磁盘响应慢会导致数据库进程挂起,进而阻塞CSS Agent和LMS进程。LMS进程负责处理Cache Fusion消息,如果它因等待I/O而长时间不运行,其他节点会认为该节点已死,从而发起驱逐。这种现象在ASM磁盘组响应缓慢或存储阵列拥塞时尤为常见。因此,监控ASM磁盘的响应时间是预防驱逐的重要环节。


