






如何从文本中提取所有匹配的正则子串
使用regexp_matches()函数可以从字符串中提取符合正则表达式的所有子串。该函数返回一个text[]数组,其中包含所有匹配项。如果希望获取所有匹配而非仅第一个,需要添加'g'标志位。
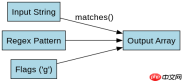
SELECT regexp_matches('hello world, foo bar', '[a-z]+', 'g');
上述查询将返回一个包含四个元素的数组:{hello,world,foo,bar}。如果不加'g'标志,默认只返回第一个匹配项。regexp_matches()是处理多匹配场景的首选工具,因为它能一次性返回所有结果,而无需在应用层循环调用substring()或position()。
如何提取特定捕获组的内容
当正则表达式中包含括号定义的捕获组时,regexp_matches()会返回一个包含捕获组内容的数组,而不是整个匹配字符串。这对于提取结构化数据(如日期、ID、键值对)非常有用。
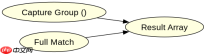
SELECT regexp_matches('user: alice, age: 30', 'age: (\d+)', 'g');
上述查询将返回一个包含单个元素的数组:{30}。注意,数组的第一个元素是整个匹配部分(如果未指定捕获组),但在这里我们只关心捕获组(\d+)的内容。如果正则中有多个捕获组,数组将按顺序包含它们。例如,regexp_matches('a=1,b=2', '(\w)=(\d)')` 将返回 {a,1} 和 {b,2}(配合'g'标志)。这种机制允许你直接获取感兴趣的部分,避免后续字符串处理。
当输入为空或无匹配时会发生什么
如果输入字符串为NULL,regexp_matches()返回NULL。如果输入非空但没有找到任何匹配项,函数返回NULL(而不是空数组)。这一行为在处理可能缺失的数据时需要特别注意,通常需要使用CASE语句或COALESCE()来处理这种情况。
SELECT regexp_matches(NULL, 'test'); -- Returns NULL
SELECT regexp_matches('no match here', '\d+'); -- Returns NULL
SELECT COALESCE(regexp_matches('no match here', '\d+'), ARRAY['default']); -- Returns {default}
在实际应用中,建议始终检查返回值是否为NULL,以避免在后续操作中出现错误。例如,在WHERE子句中直接使用regexp_matches()可能导致意外结果,因为NULL不等于任何值。可以使用IS NOT NULL来过滤掉无匹配的行。


